AI翻唱使用心得
炼丹!
暑假的时候突然对“炼丹”(AI翻唱)有了兴趣,捣鼓了几天才完成自己满意的作品。虽然网络上有许多相关的视频,但其实对于一个刚接触“炼丹”或者对计算机小白,很多过程还是不清晰,在摸索过程也耗费了很多的时间精力。接下来就向大家展示该如何在云端进行AI的训练。
可以参考这个up的视频:【【AI翻唱/SoVITS 4.1】手把手教你老婆唱歌给你听~无需配置环境的本地训练/推理教程[懒人整合包]】 https://www.bilibili.com/video/BV1H24y187Ko/?share_source=copy_web&vd_source=8c1429b9e179eef5f88ab01936c62ee0
对于AI的训练,可以选择本地和云端两种形式,我比较推荐大家使用云端。那为什么选择云端呢?AI的训练和模型的推算对于电脑的显卡要求特别高,如果想达到更好的训练效果,一张好的显卡是必不可少的,但大部分人都难以达到这个要求,所以在云端训练是最好的选择。
第一步:准备数据集
准备用于训练的数据集,数据集要求使用干声。至于如何去获得这些干声数据,如果你想训练明日方舟里的角色,可以去$wiki$里下载语音包。其他游戏的角色的数据集可以在网上获得,最好的干声时长是30分钟左右。这里以我训练缪尔赛思的声音为例:
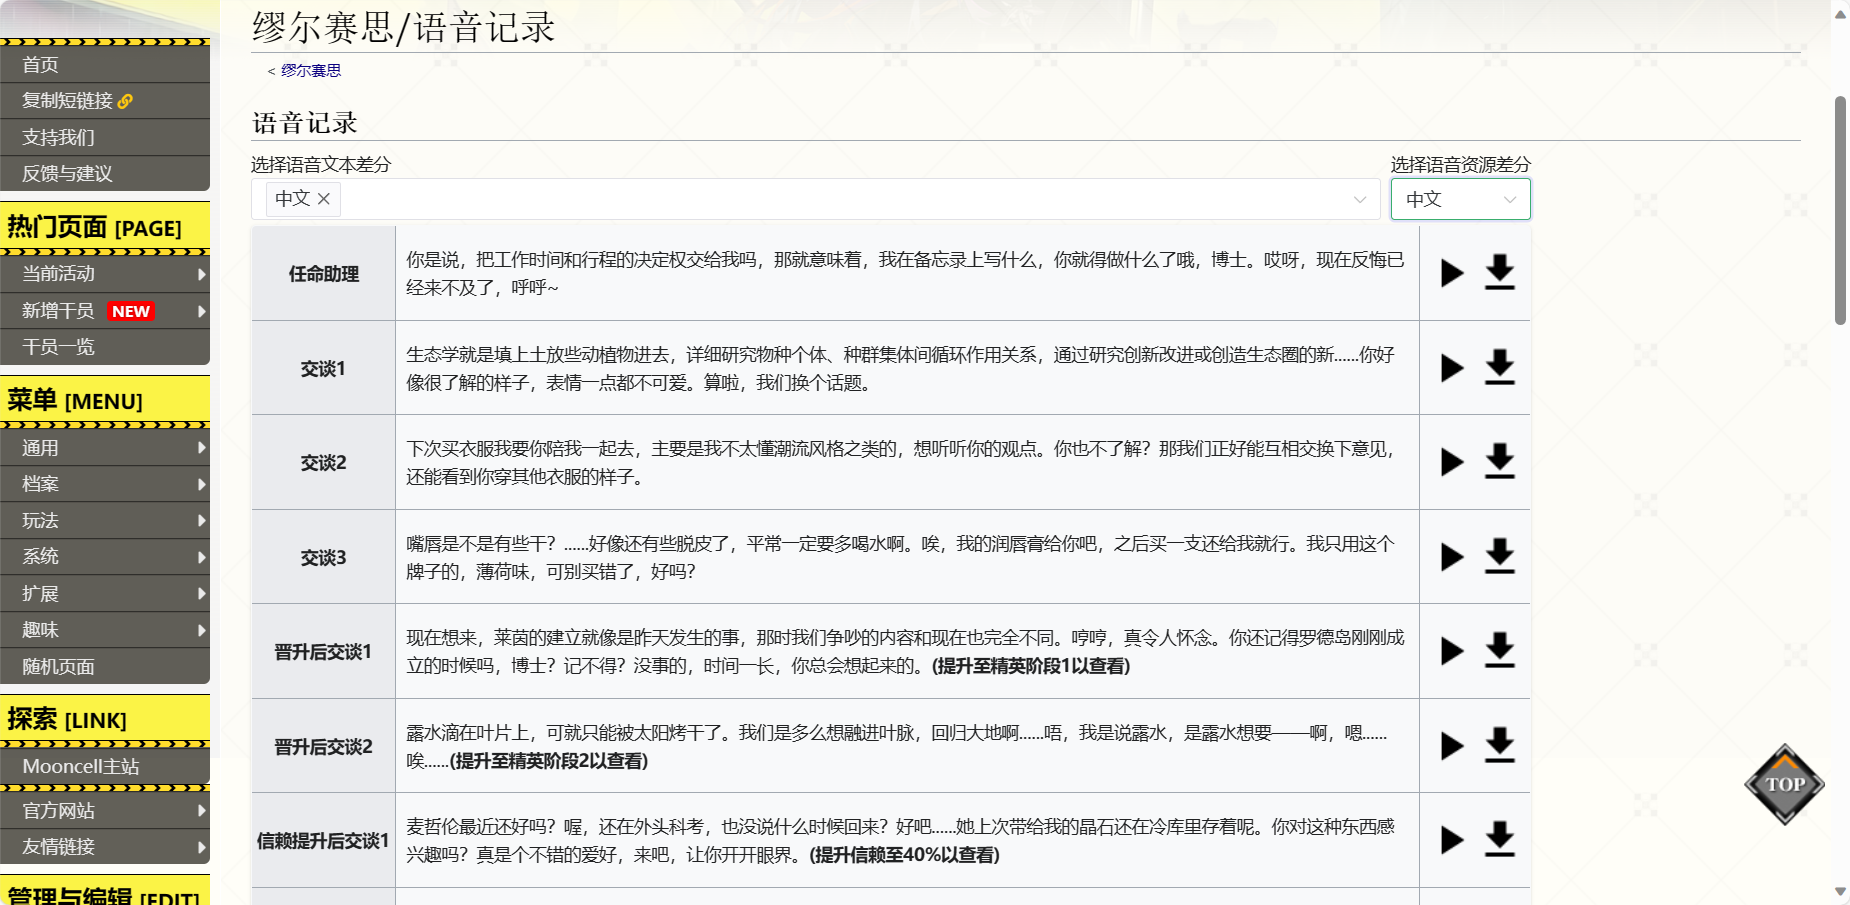
在这里获得音乐资源之后,放入一个文件夹里,注意文件夹和声音文件命名时最好不要有中文。
接下来就是对数据集进行切片处理。
需要用到上方视频里up羽毛布团提供的整合包。
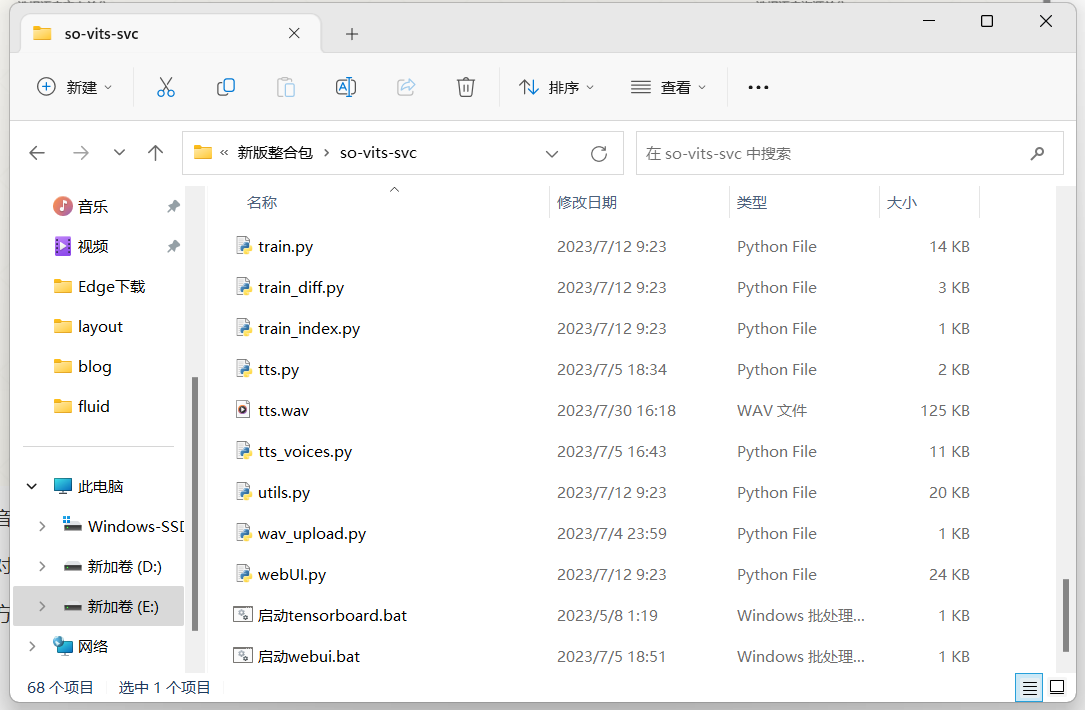
点击最下方的$启动webui.bat$。
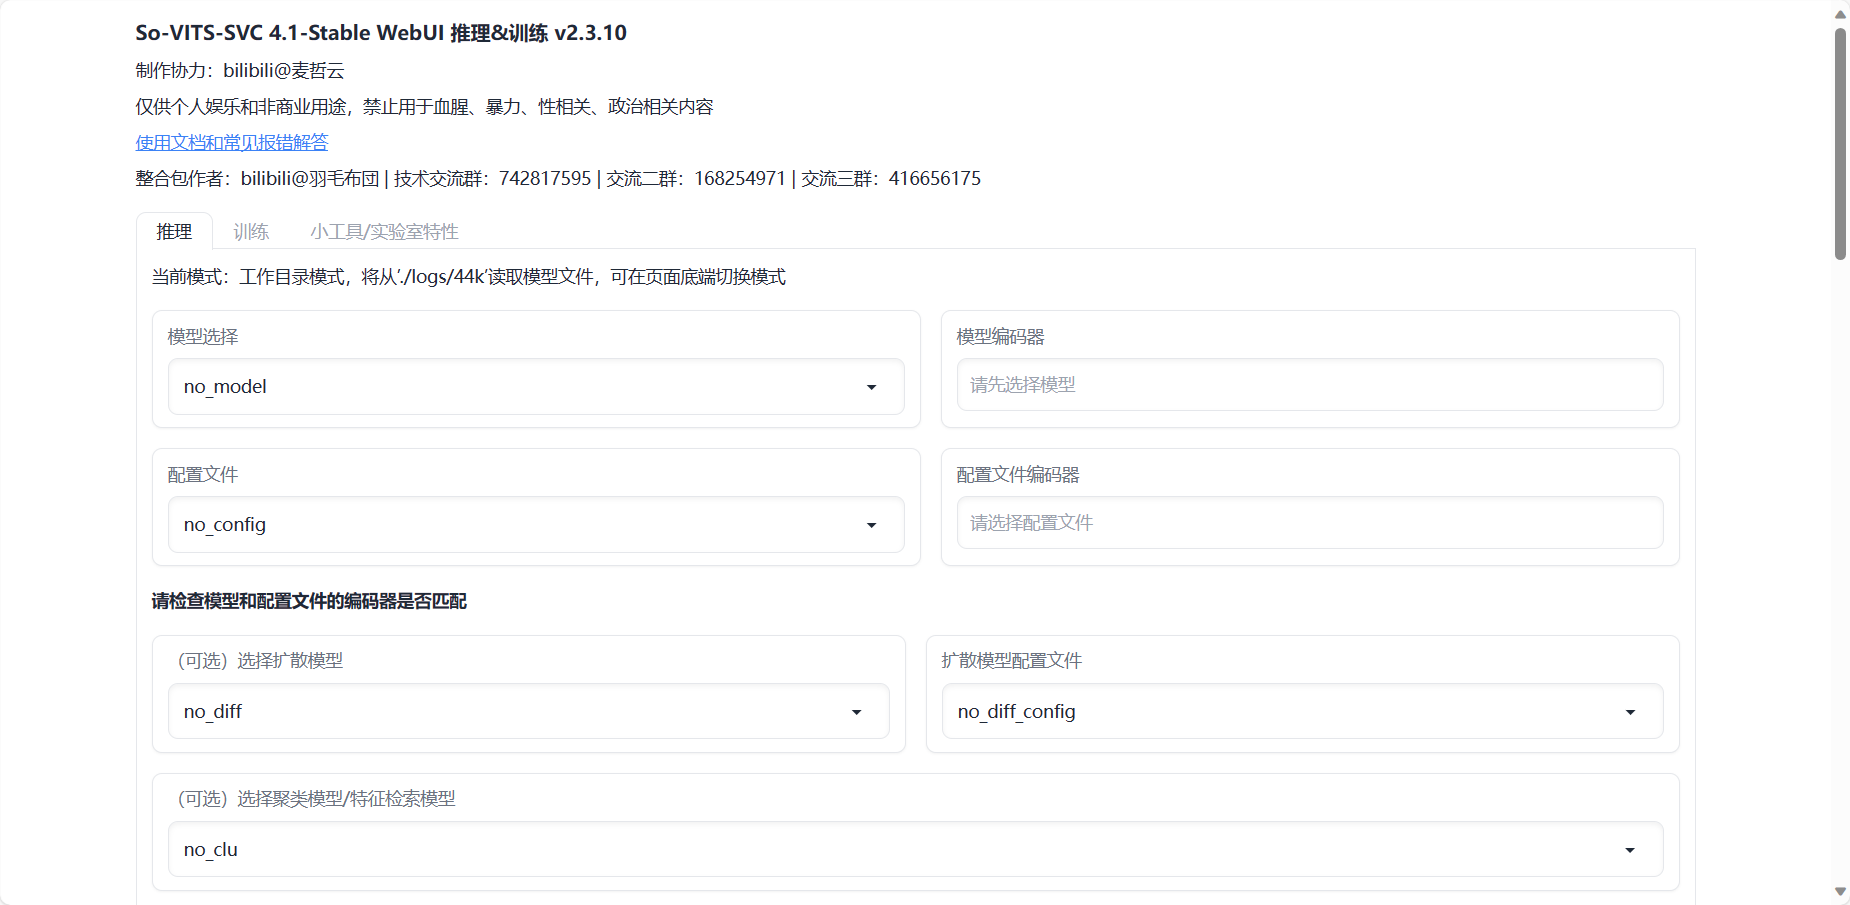
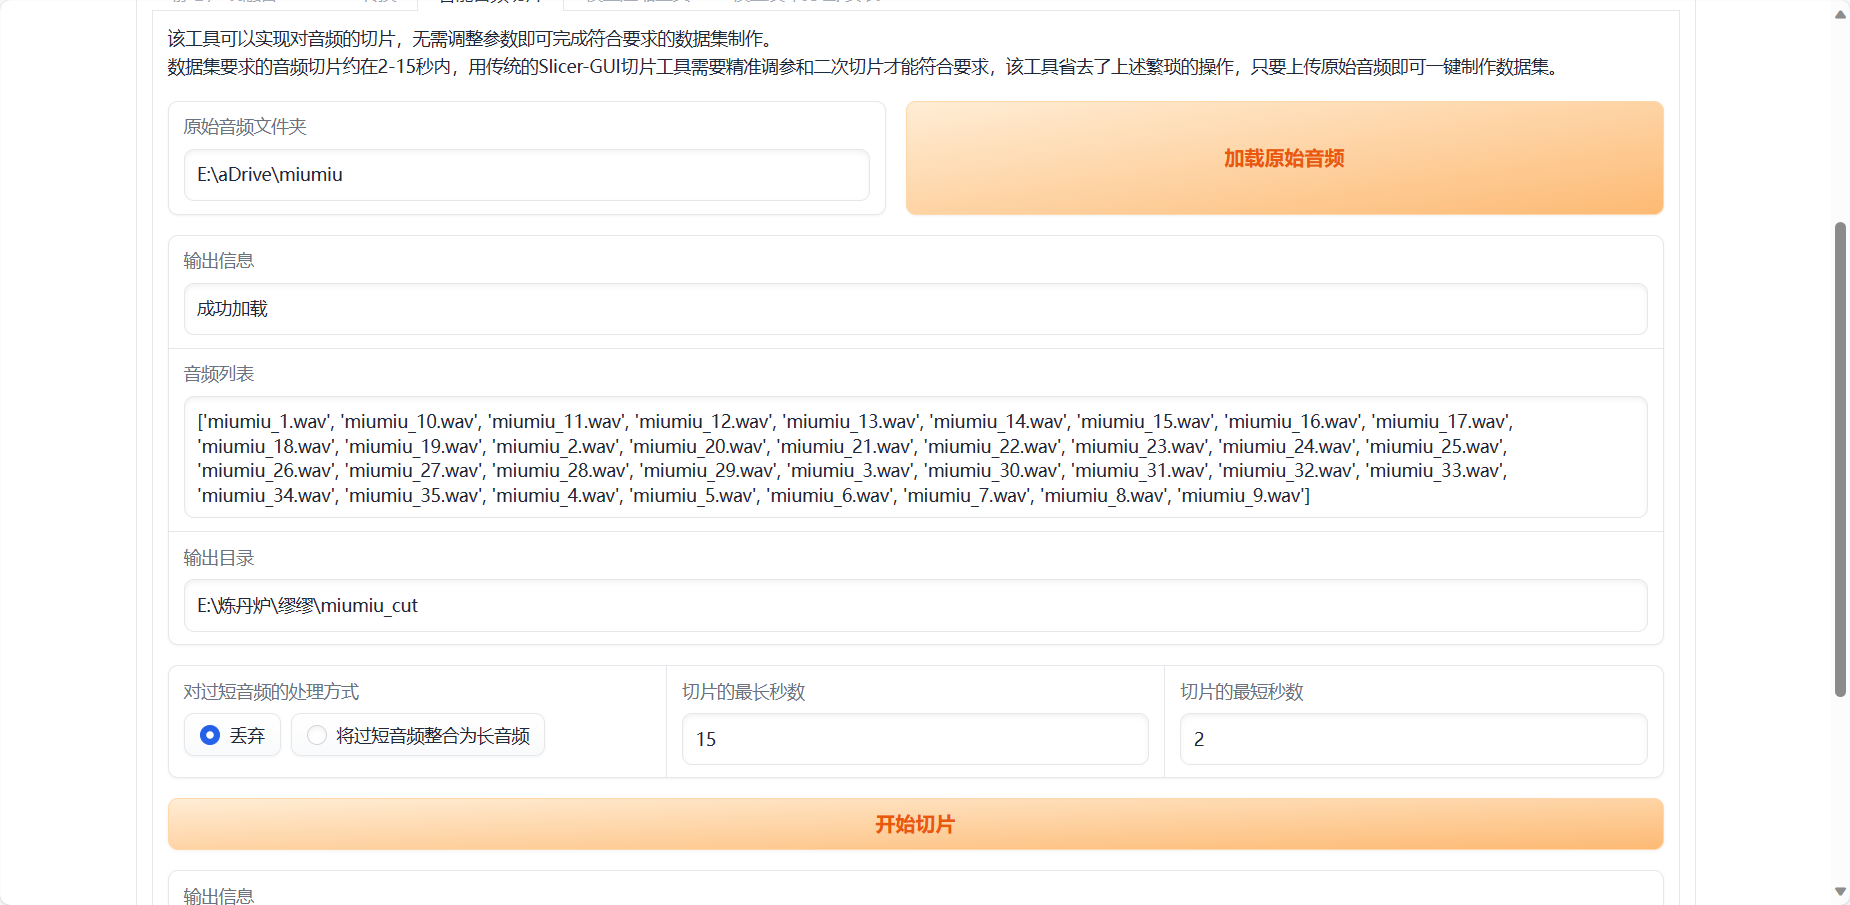
整合包是用于本地训练的,并不是我们的重点,我们只需要用到里面的剪切工具。点开上方的小工具,并选择智能音频切片:
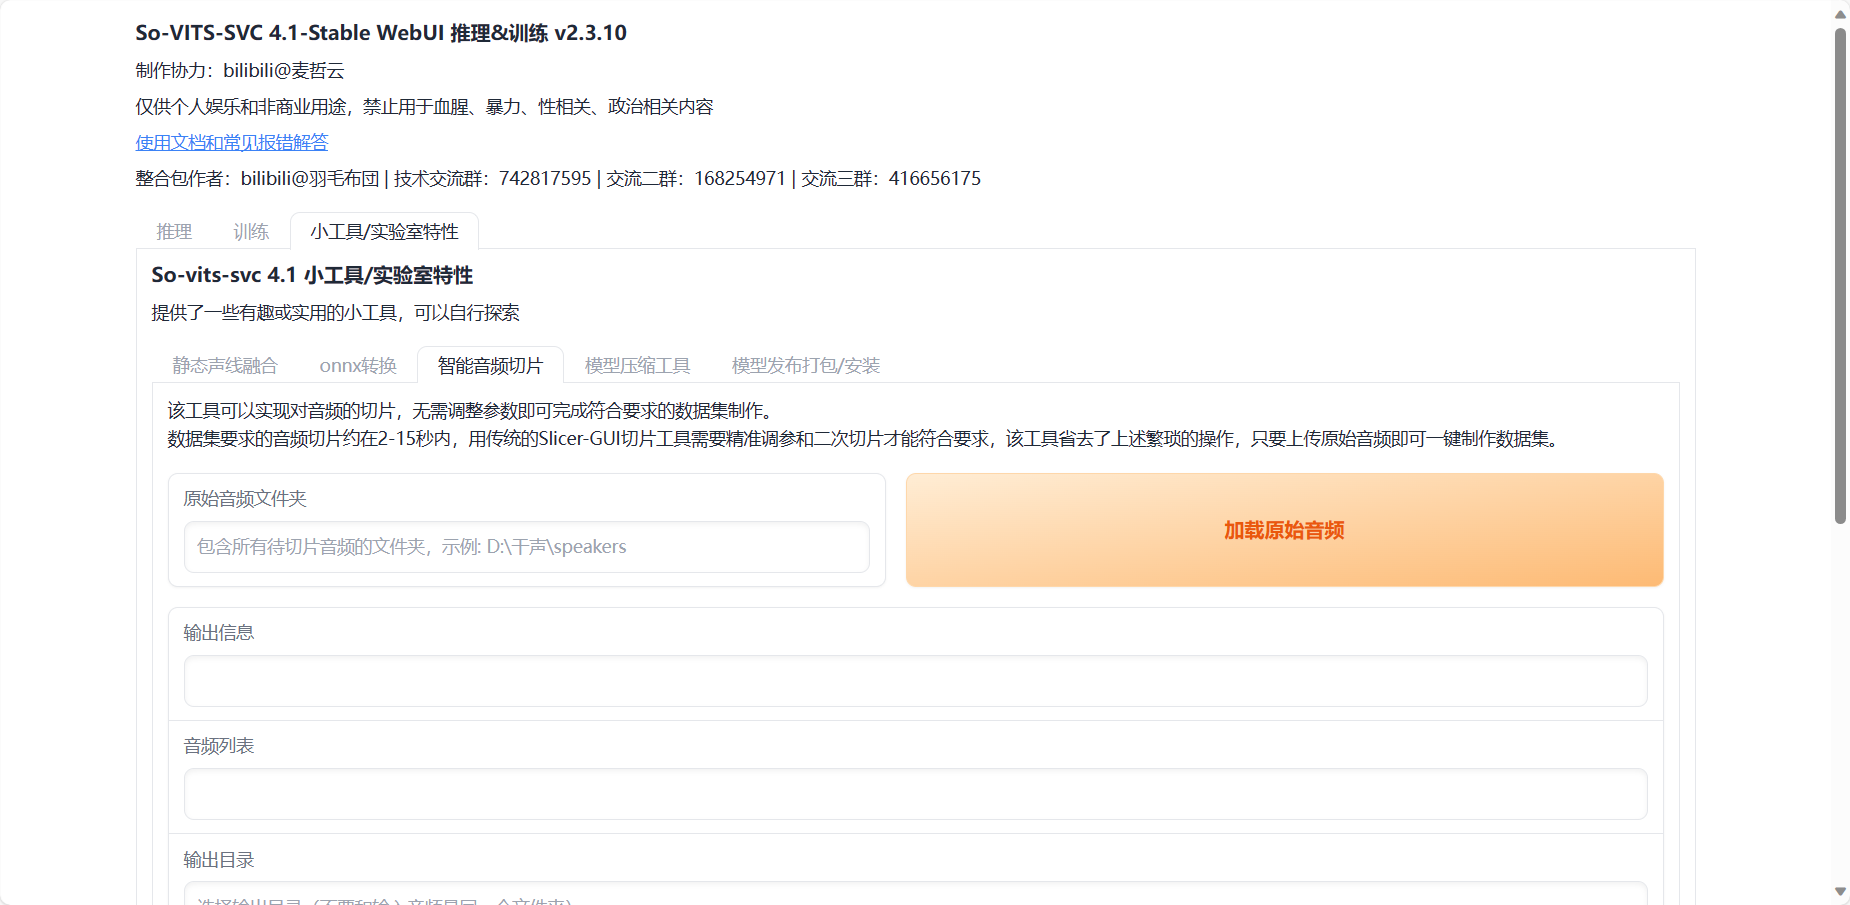
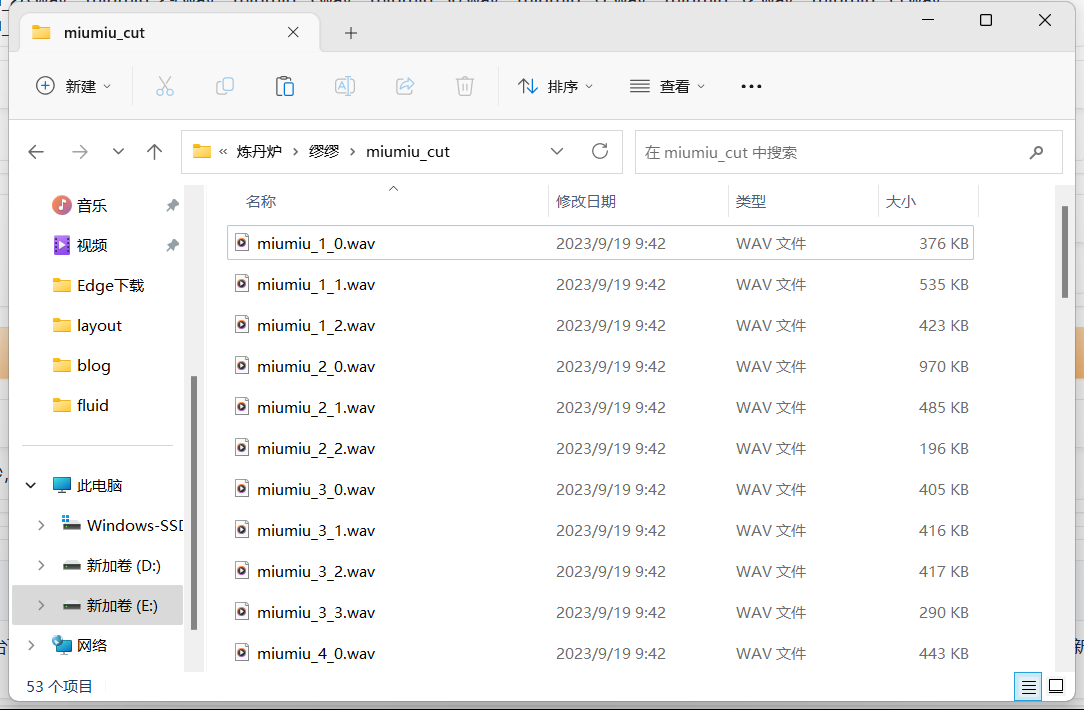
将数据集放入原始音频文件夹,点击开始切片,那这样我们就得到了一个有效的数据集。
第二步:云端训练
在云端租用显卡,我这里使用的是AutoDL:https://www.autodl.com/
注册进入后我们选择租用实例。
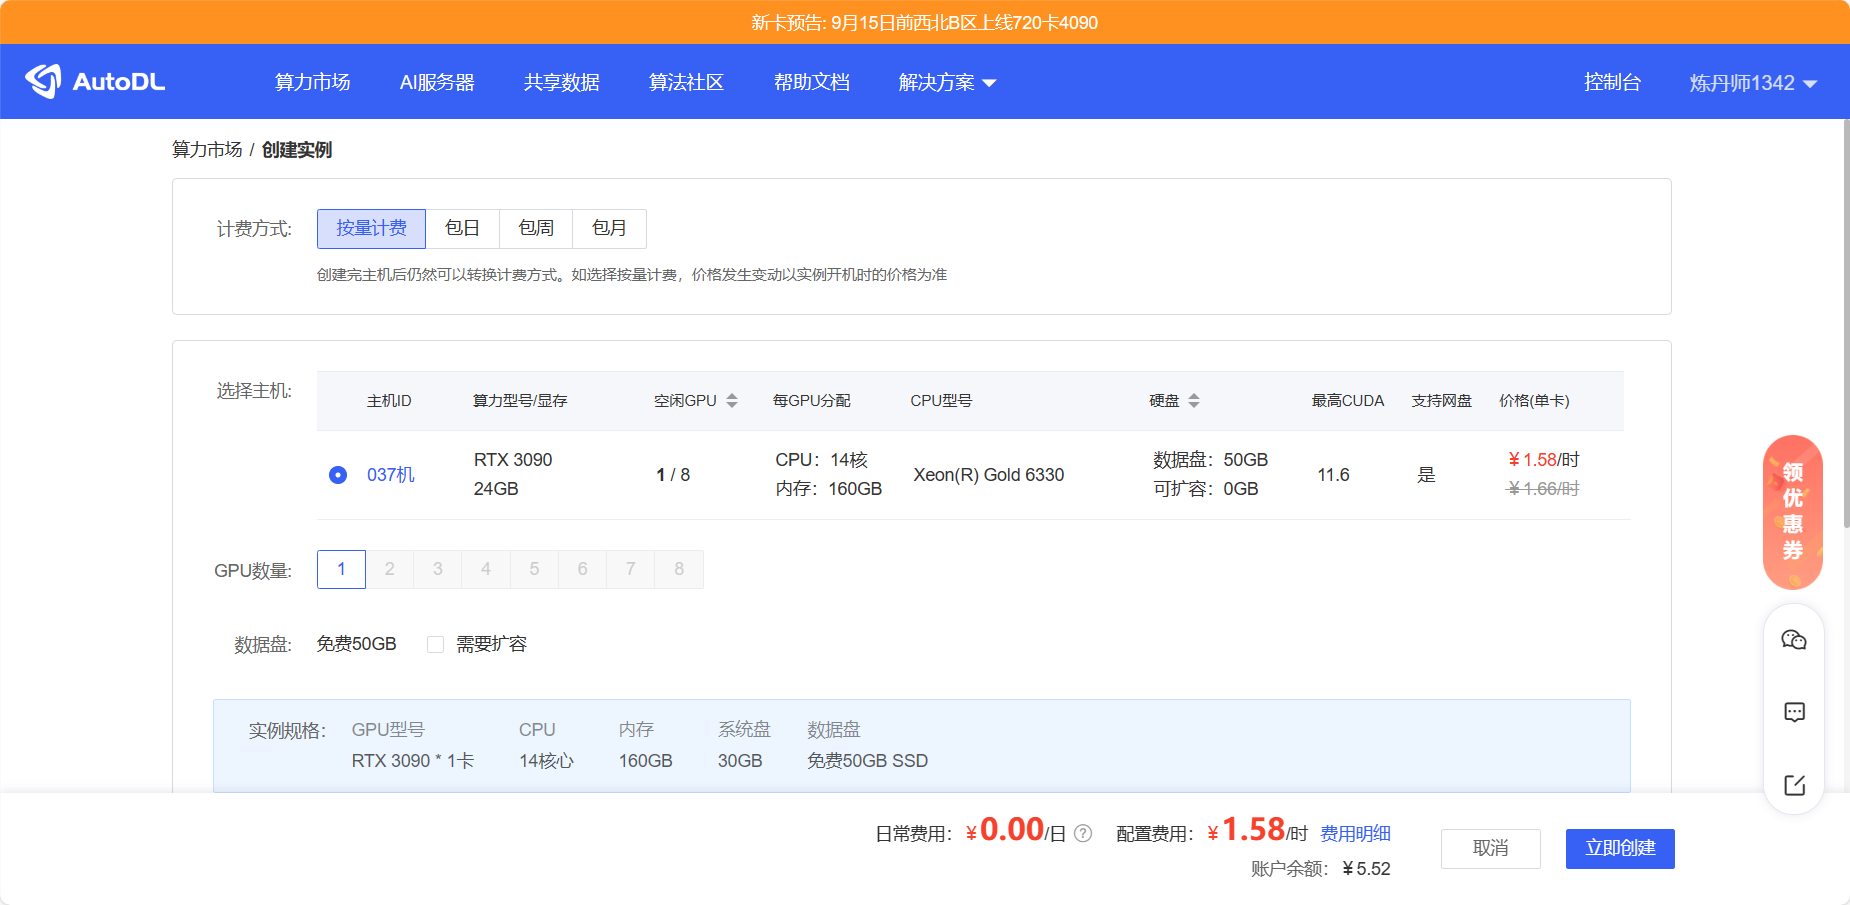
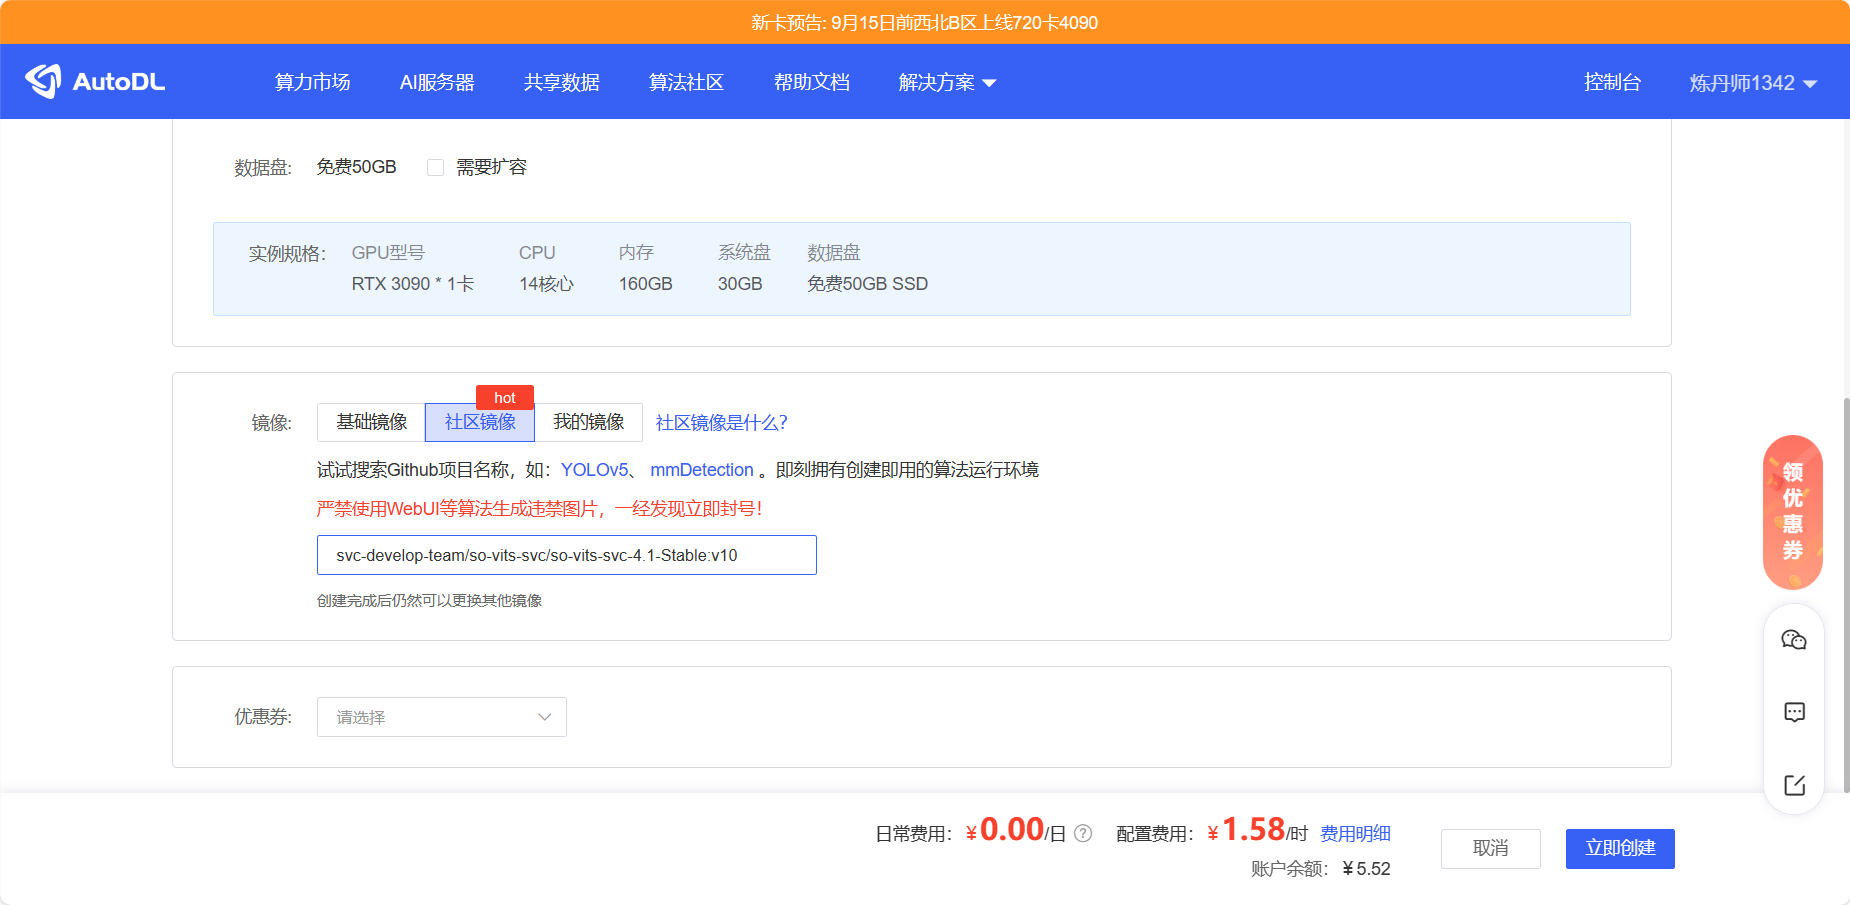
这里选择的是3090;
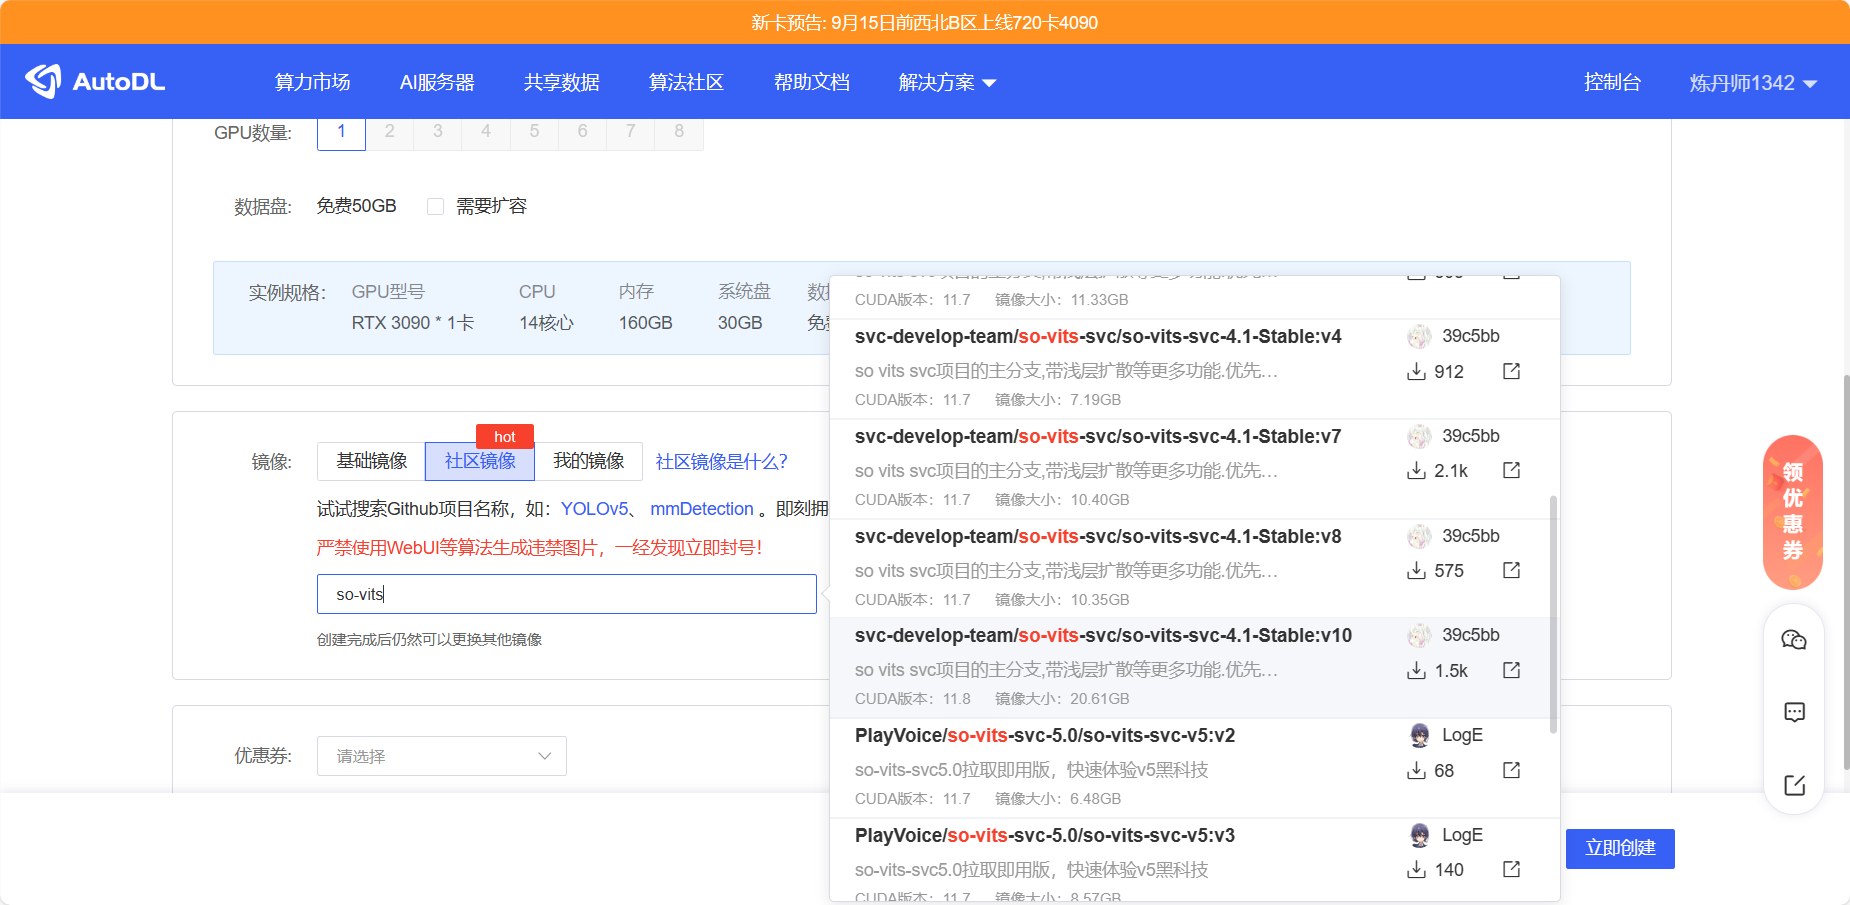
选择社区镜像,搜索$so-vits$,找到右侧的$v10$。
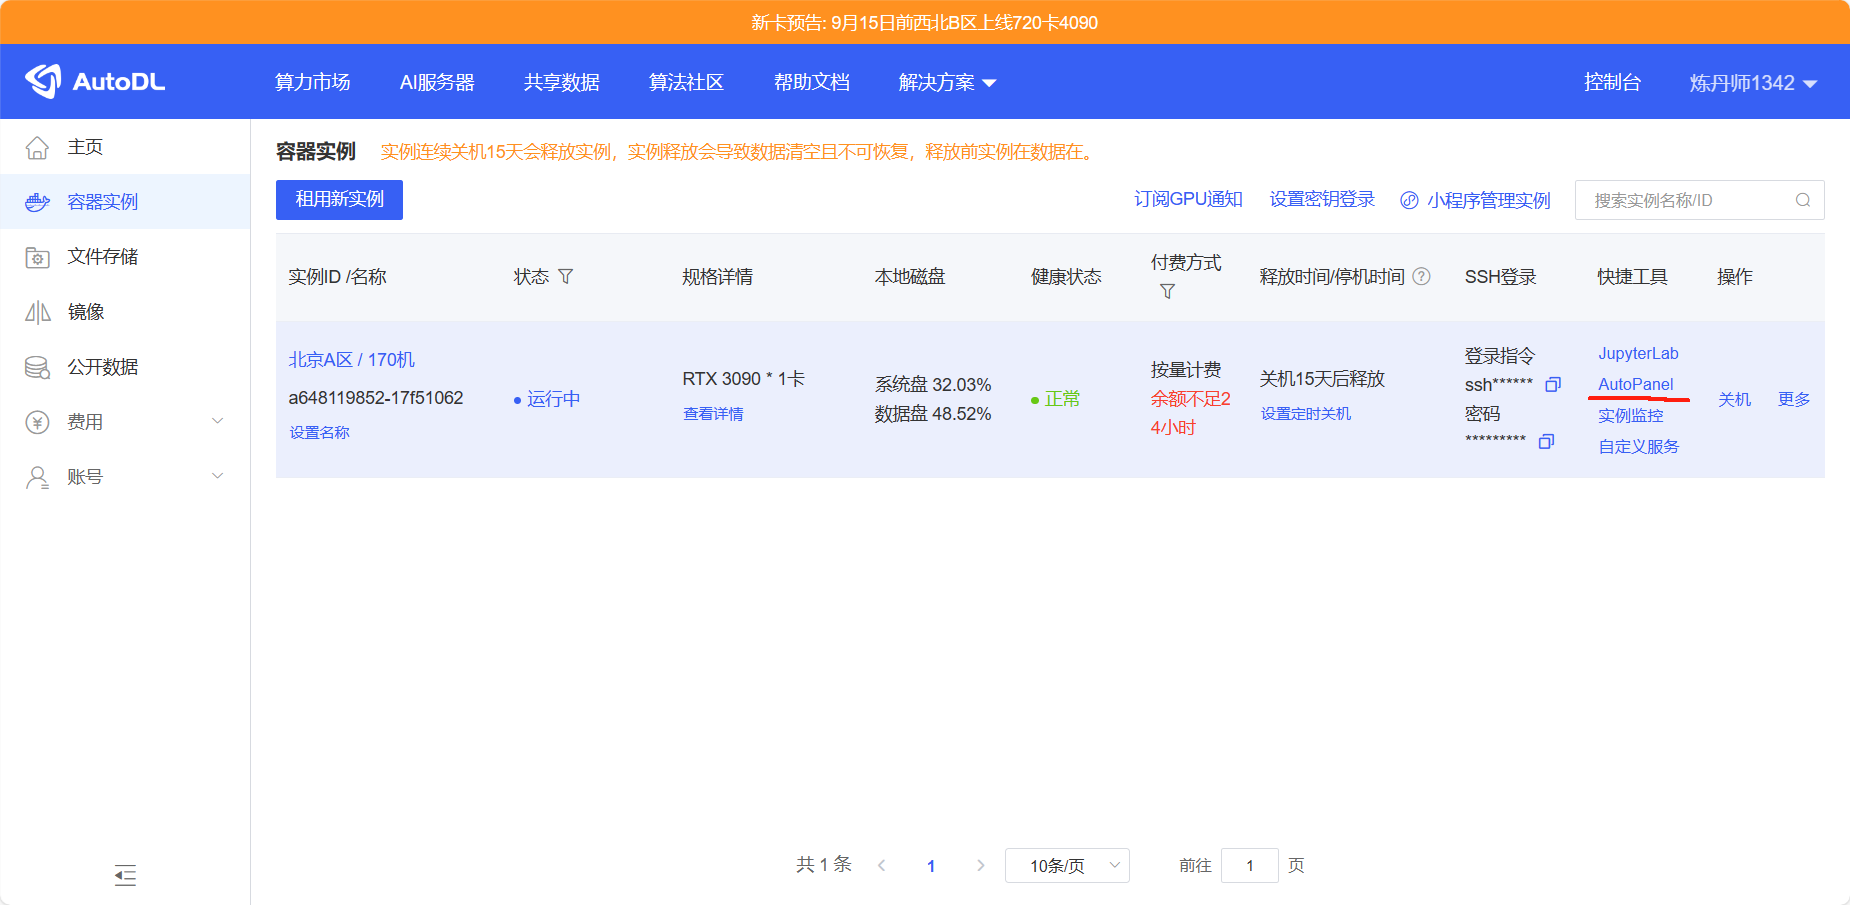
创建成功后开机,选择$AutoPanel$。
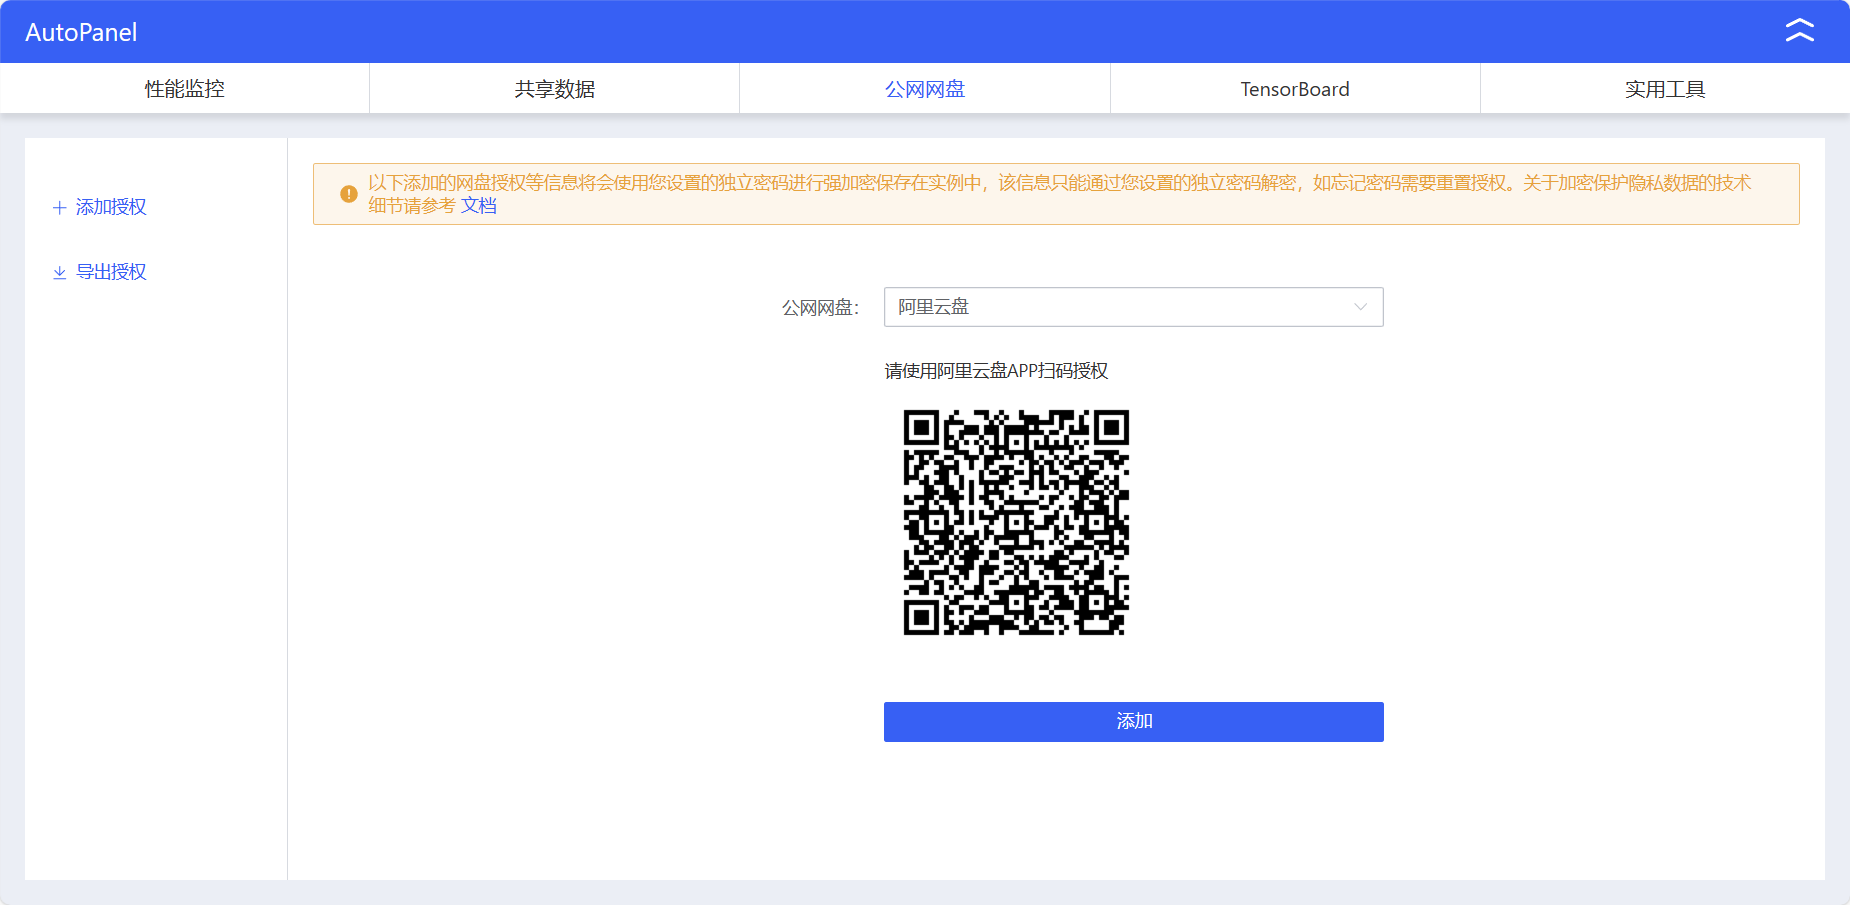
选择上方公网网盘,通过阿里云把数据集上传到云端。
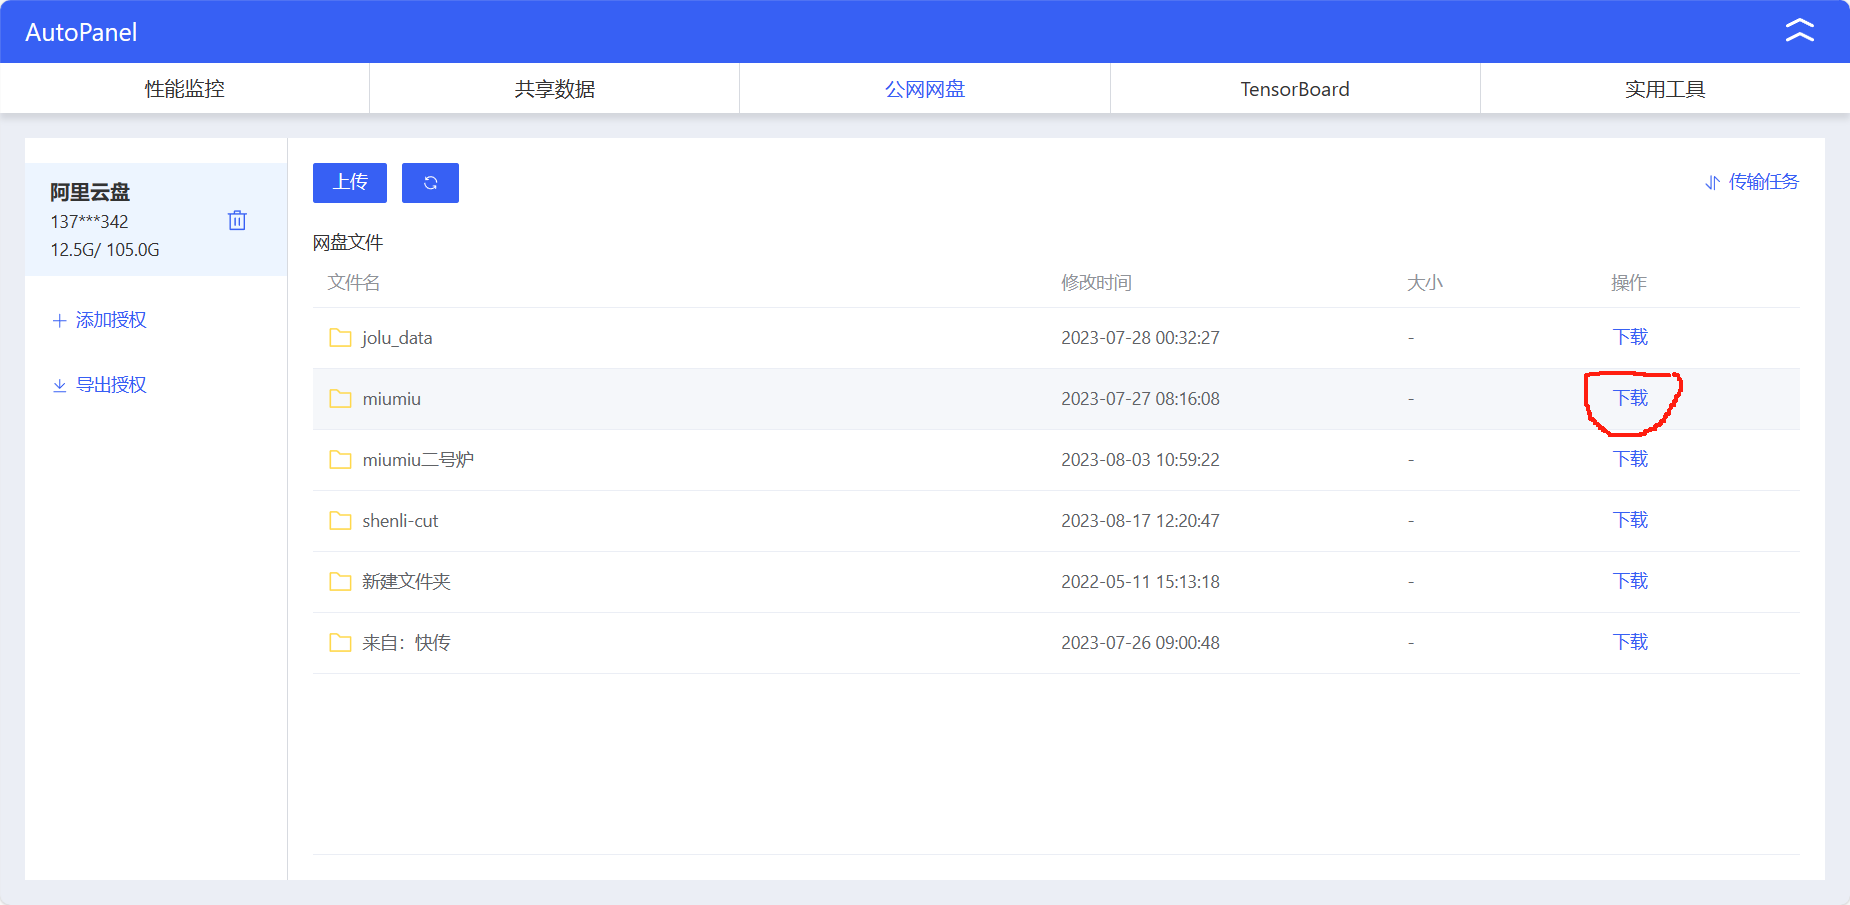
点击下载就能将数据下载到云端。
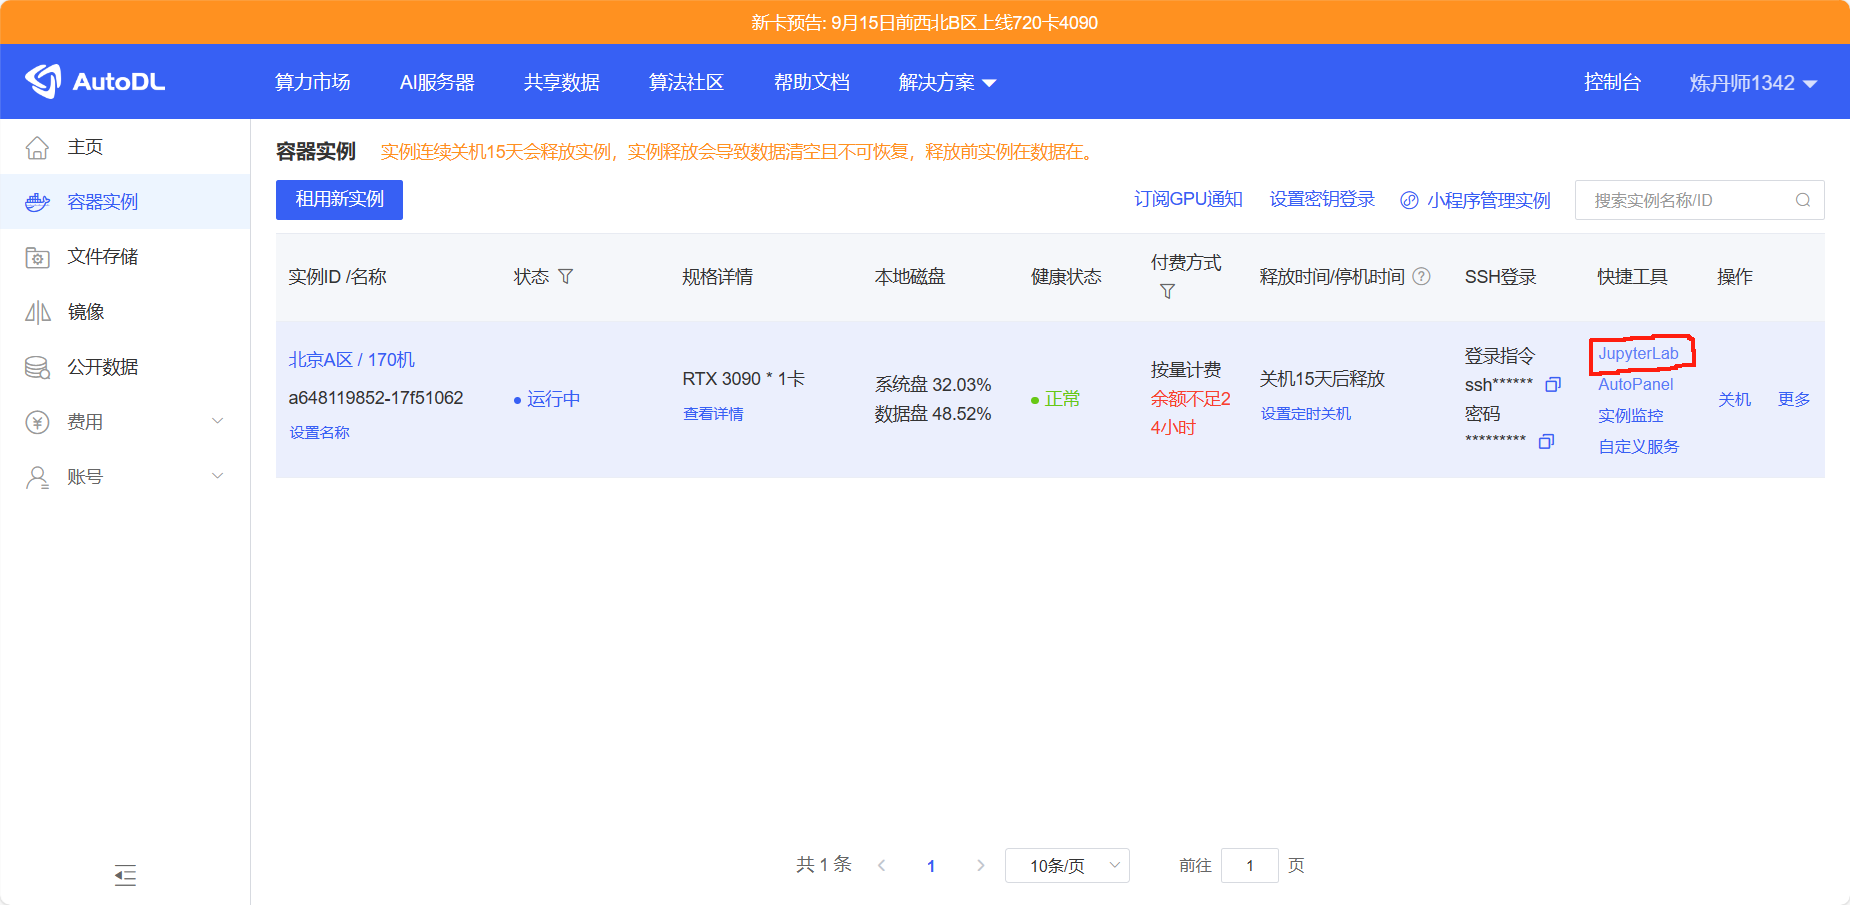
这时候回到容器实例位置,打开$JupyterLab$。
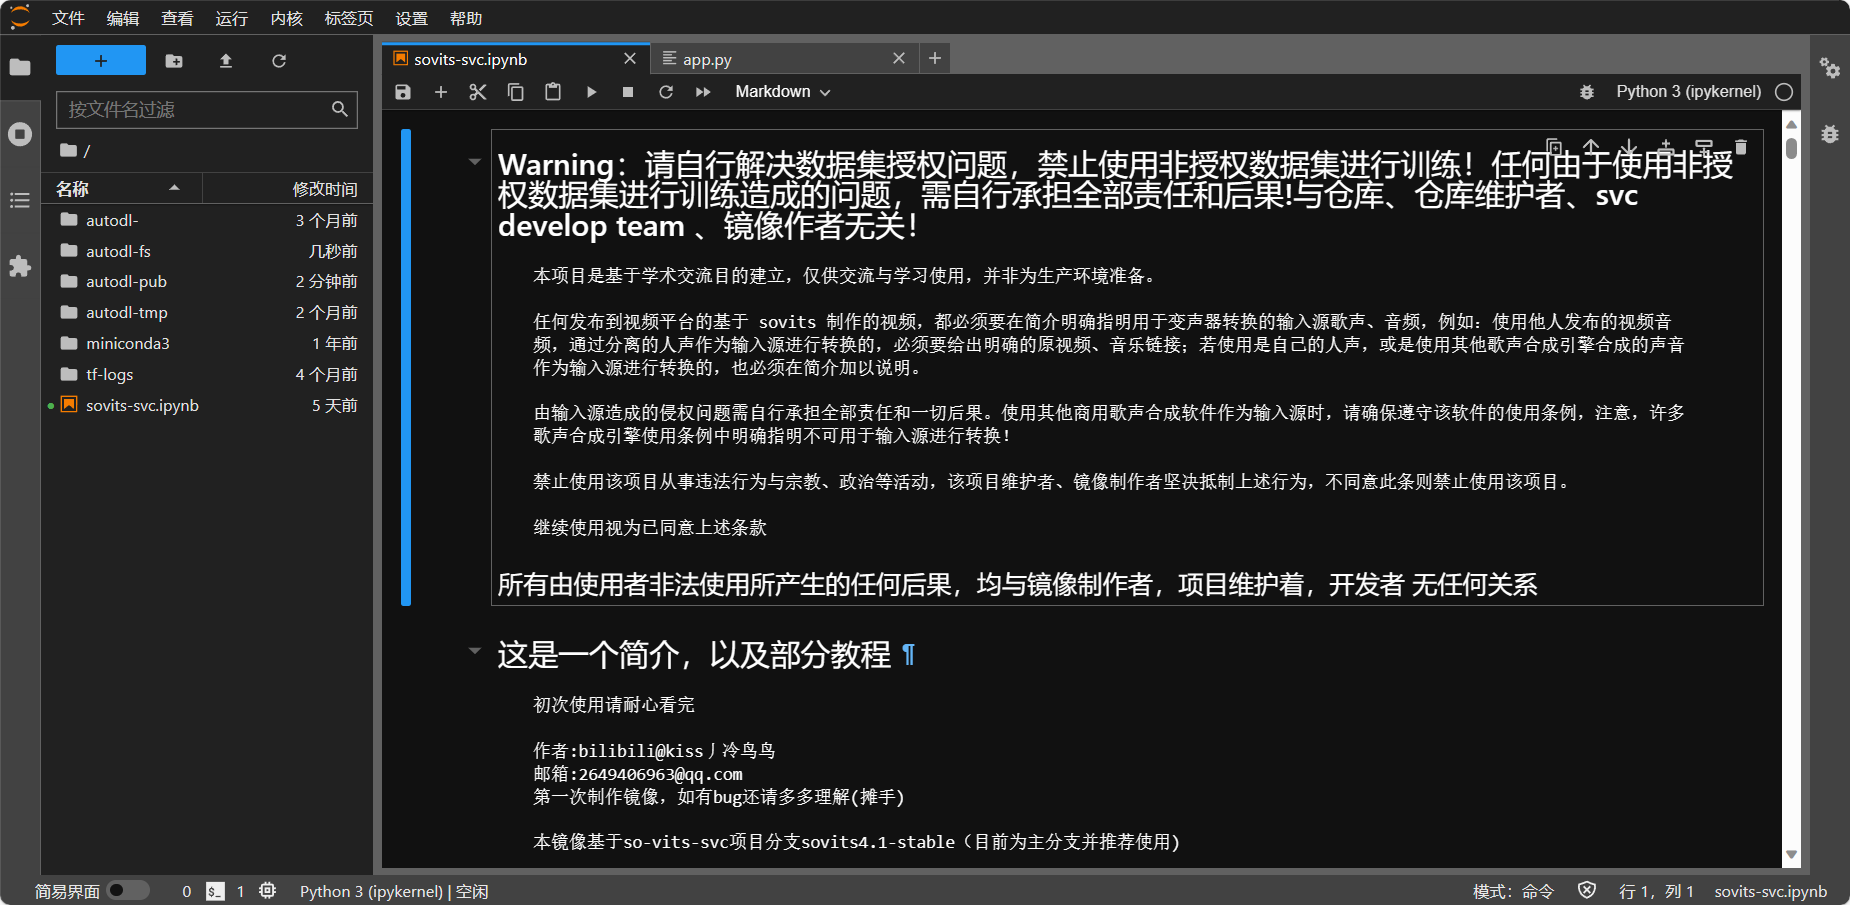
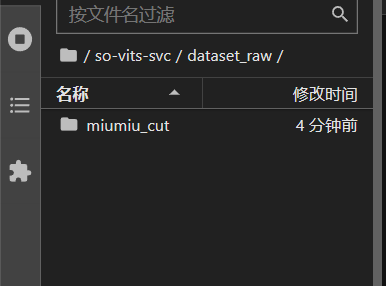
数据集存放在$/root/autodl-tmp/$文件夹中,我们需要将数据集放到so-vits里的$dataset _ raw$里。
接下来按照$ipynb$里的教程做就好了。鼠标点击要运行的代码,再点击上方的播放键开始执行。
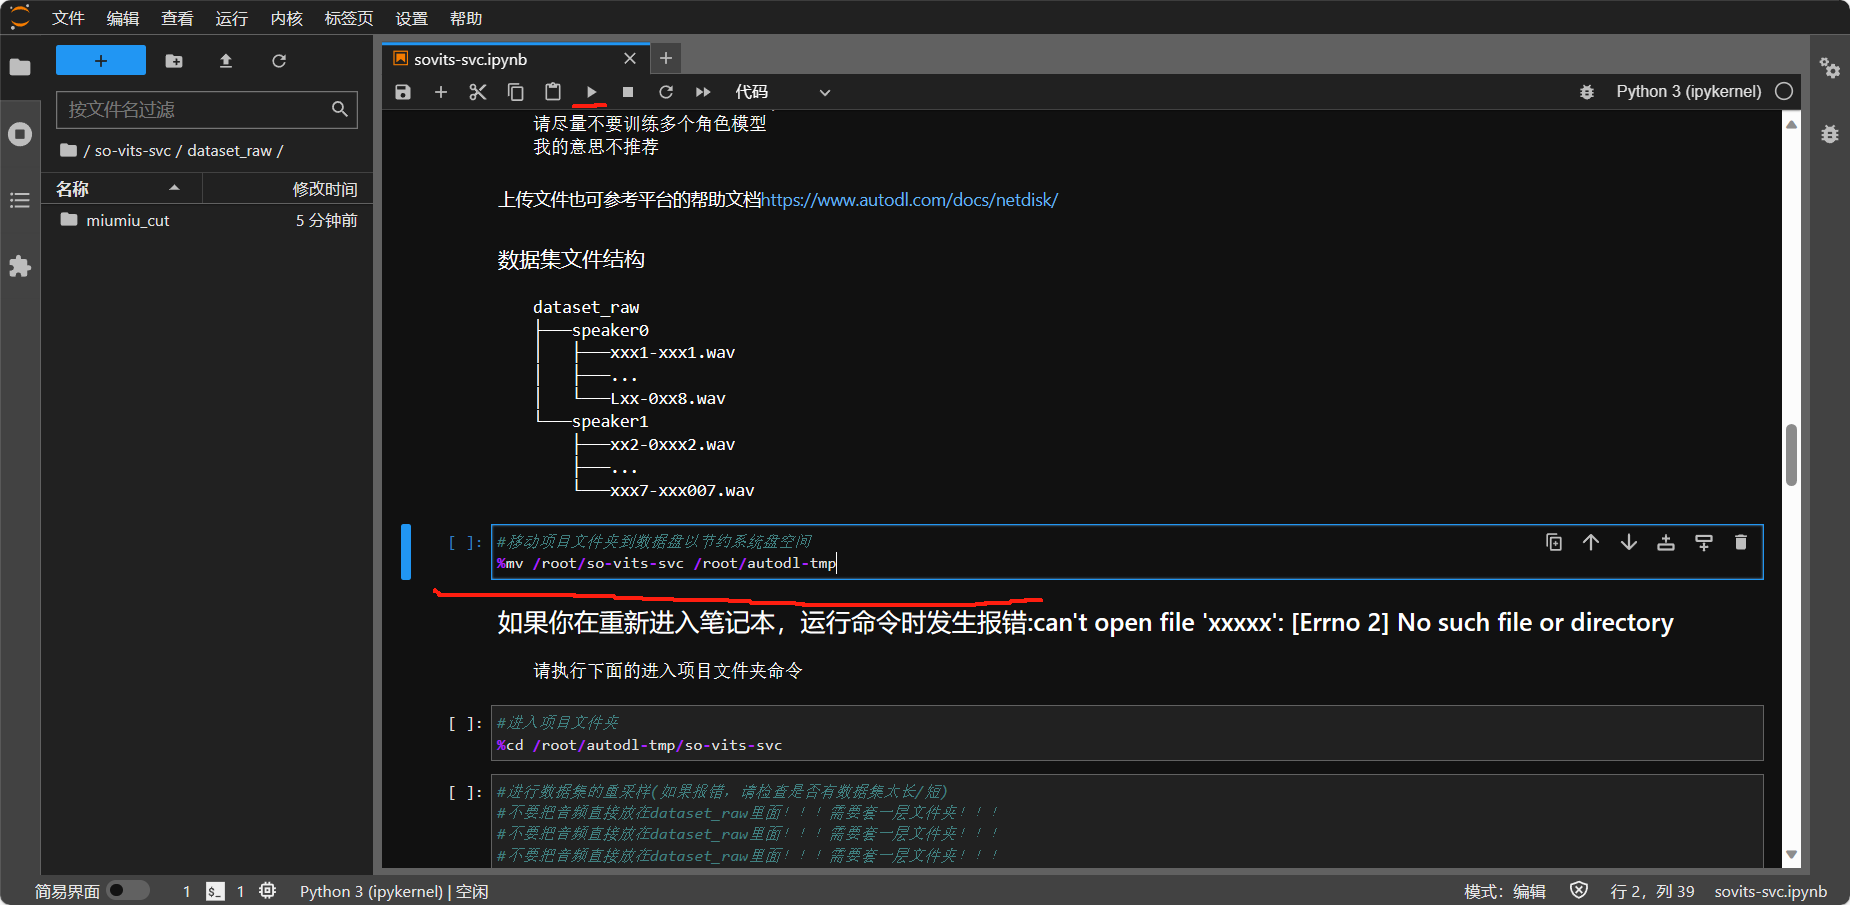
进入项目文件夹后进行数据集的重采样。
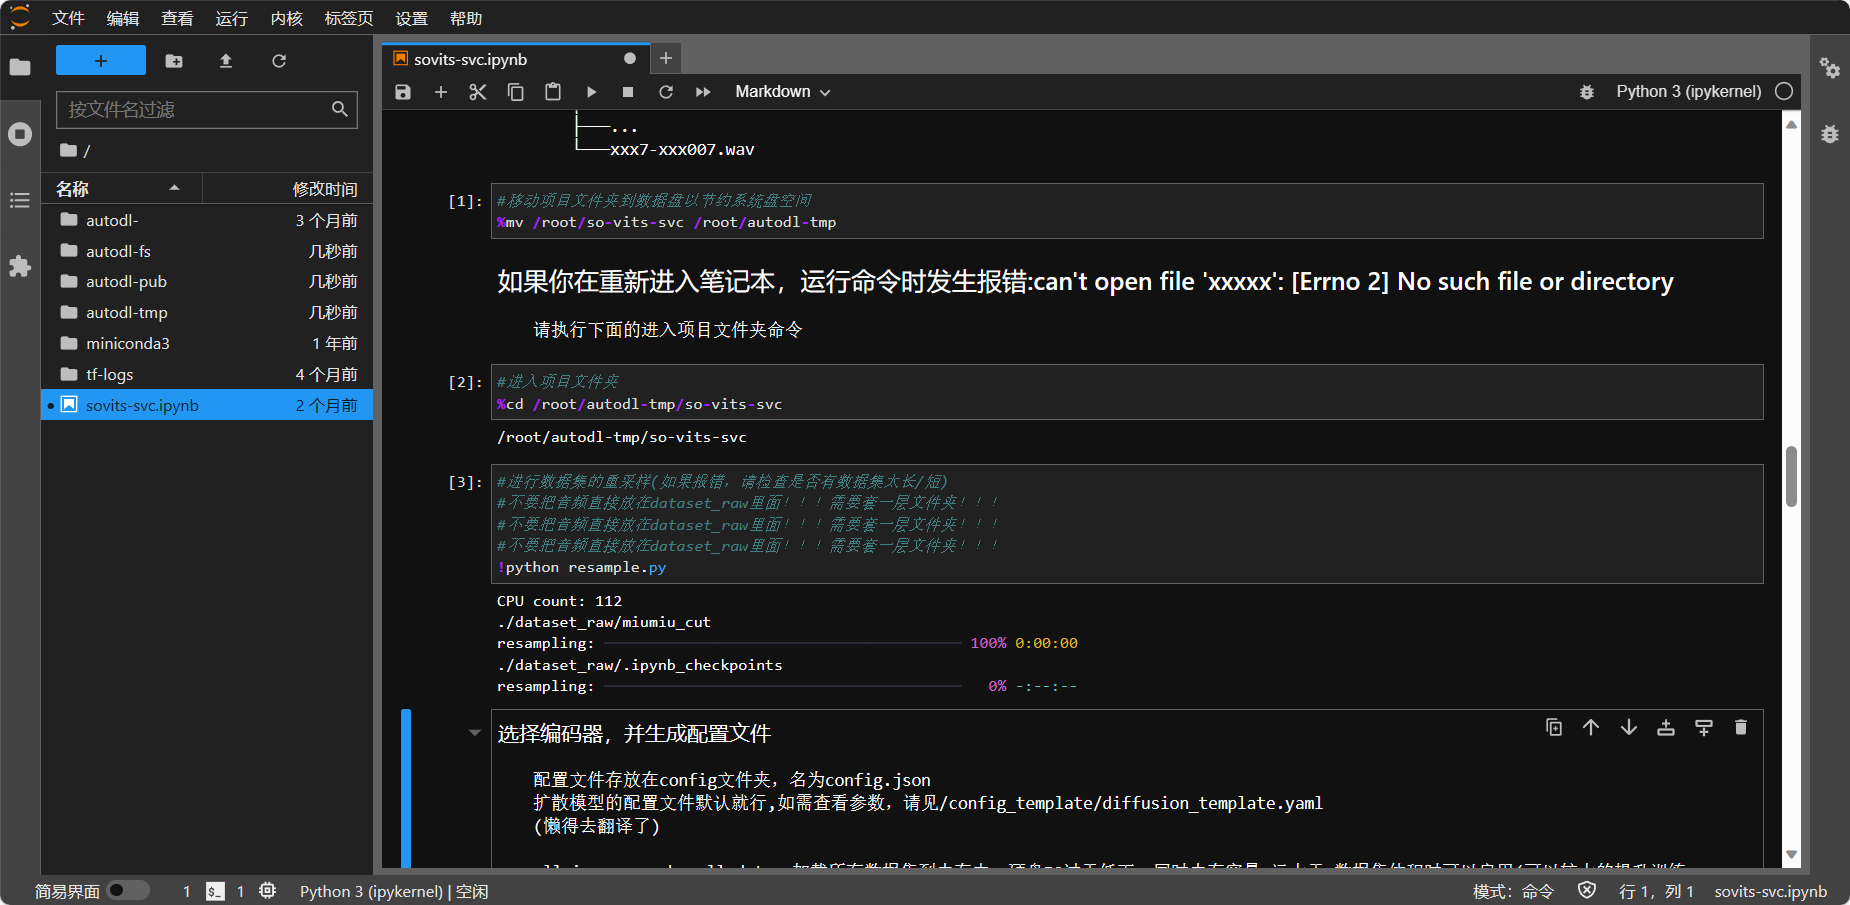
重采样完成后就可以选择编码器了。
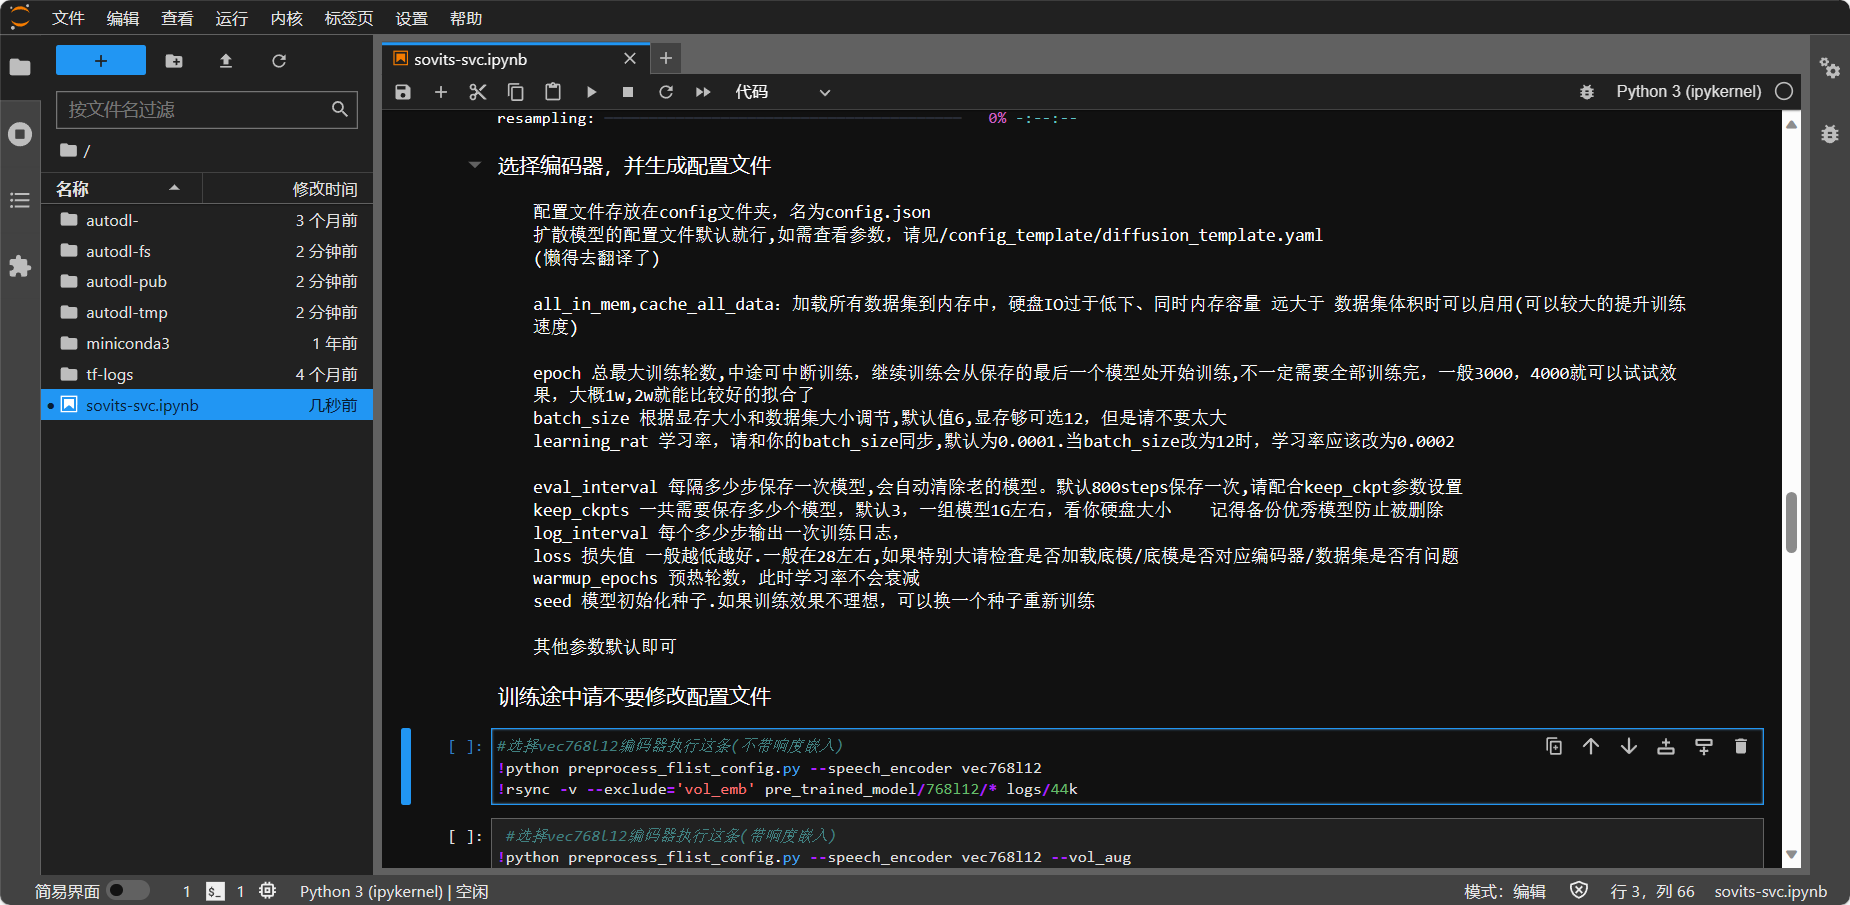
这里选择$vec768l12$编码器,点击然后运行。
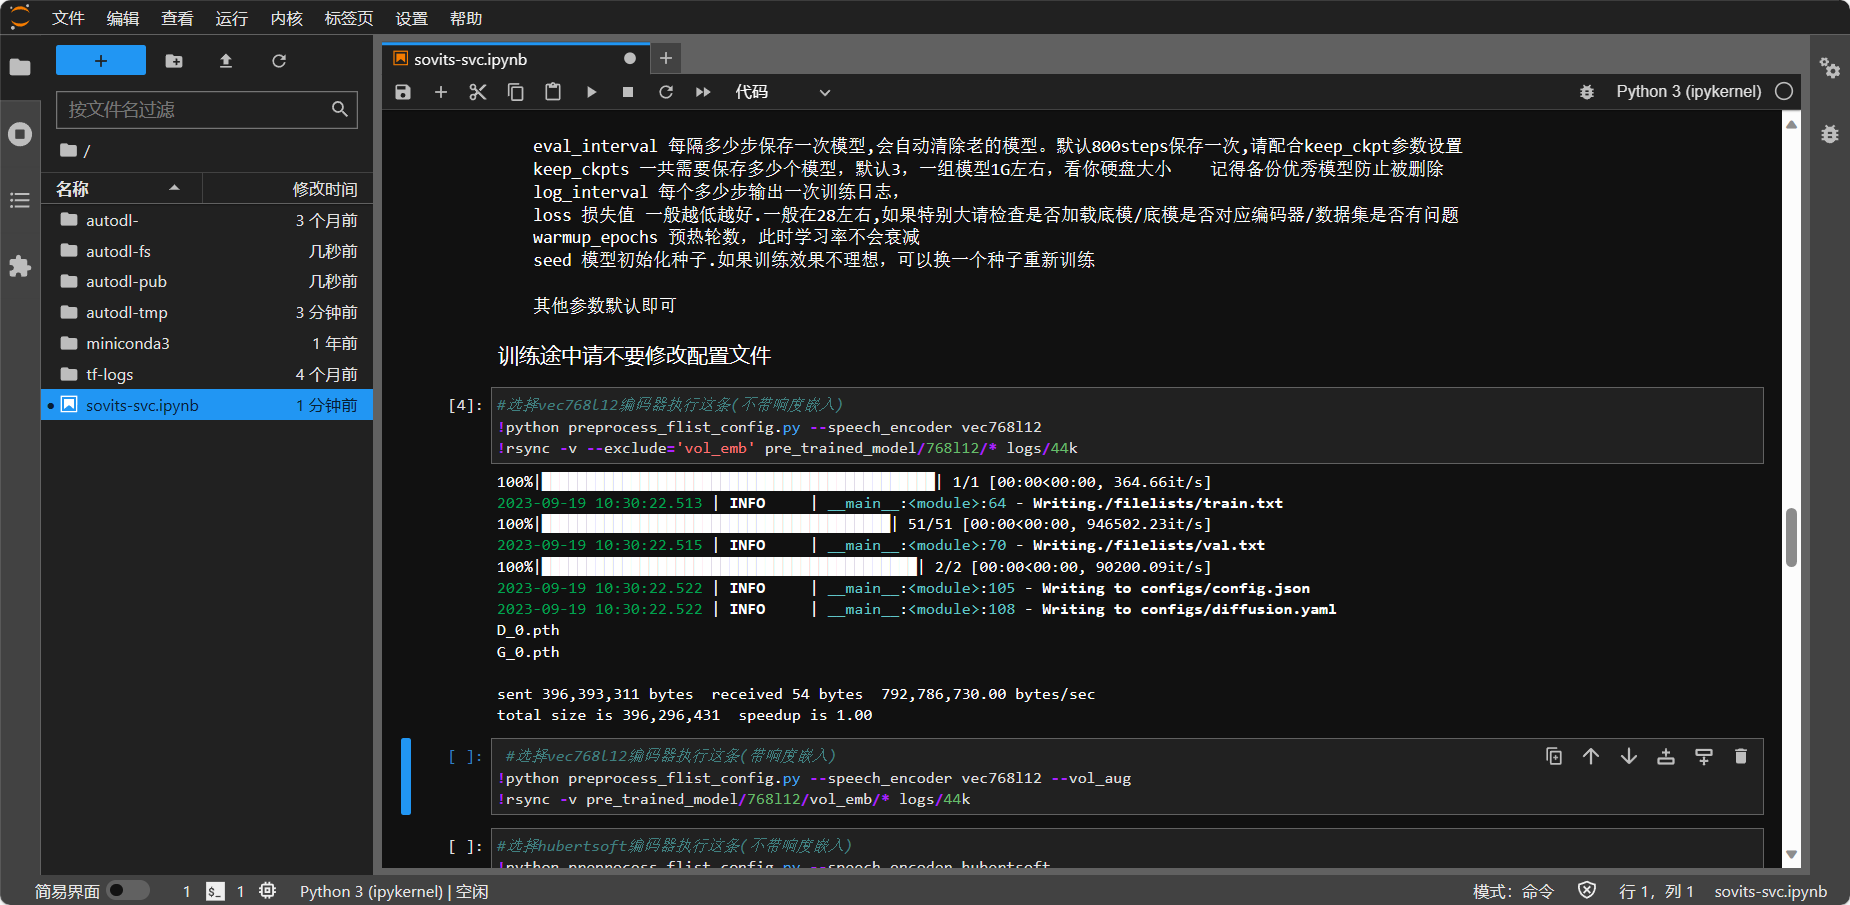
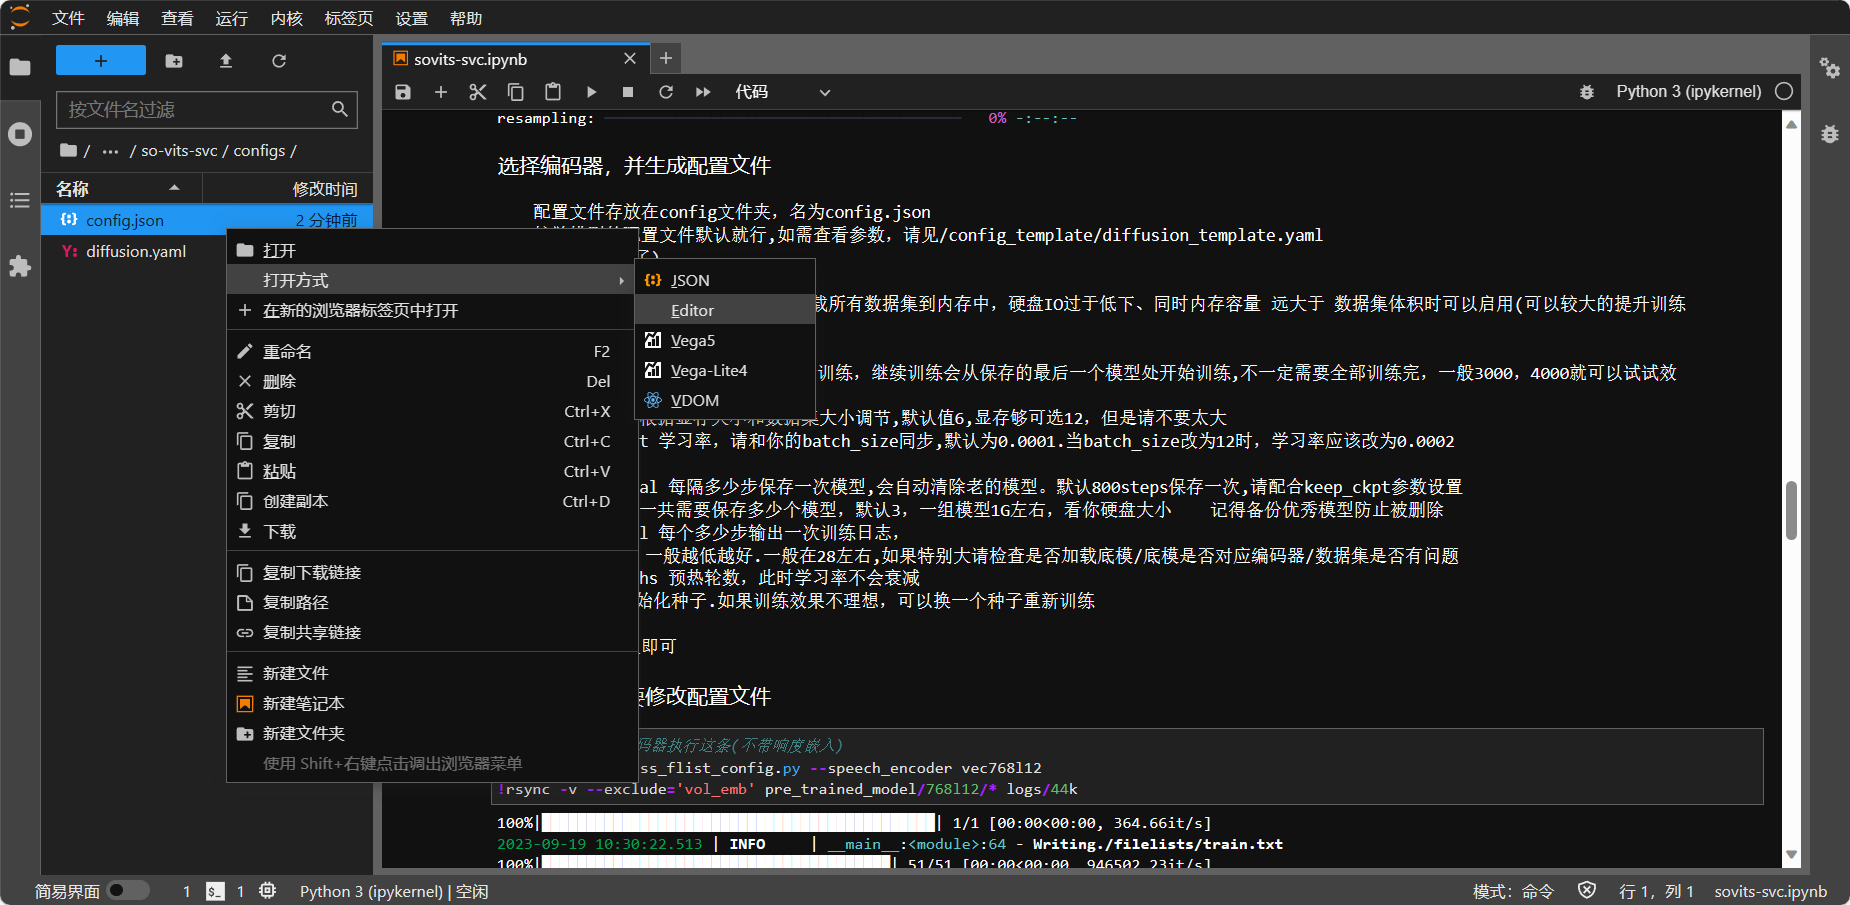
生成配置文件之后,我们需要对一些参数进行修改,找到$config.json$文件,路径是$/autodl-tmp/so-vits-svc/config$。
右键点击->打开方式->Editor
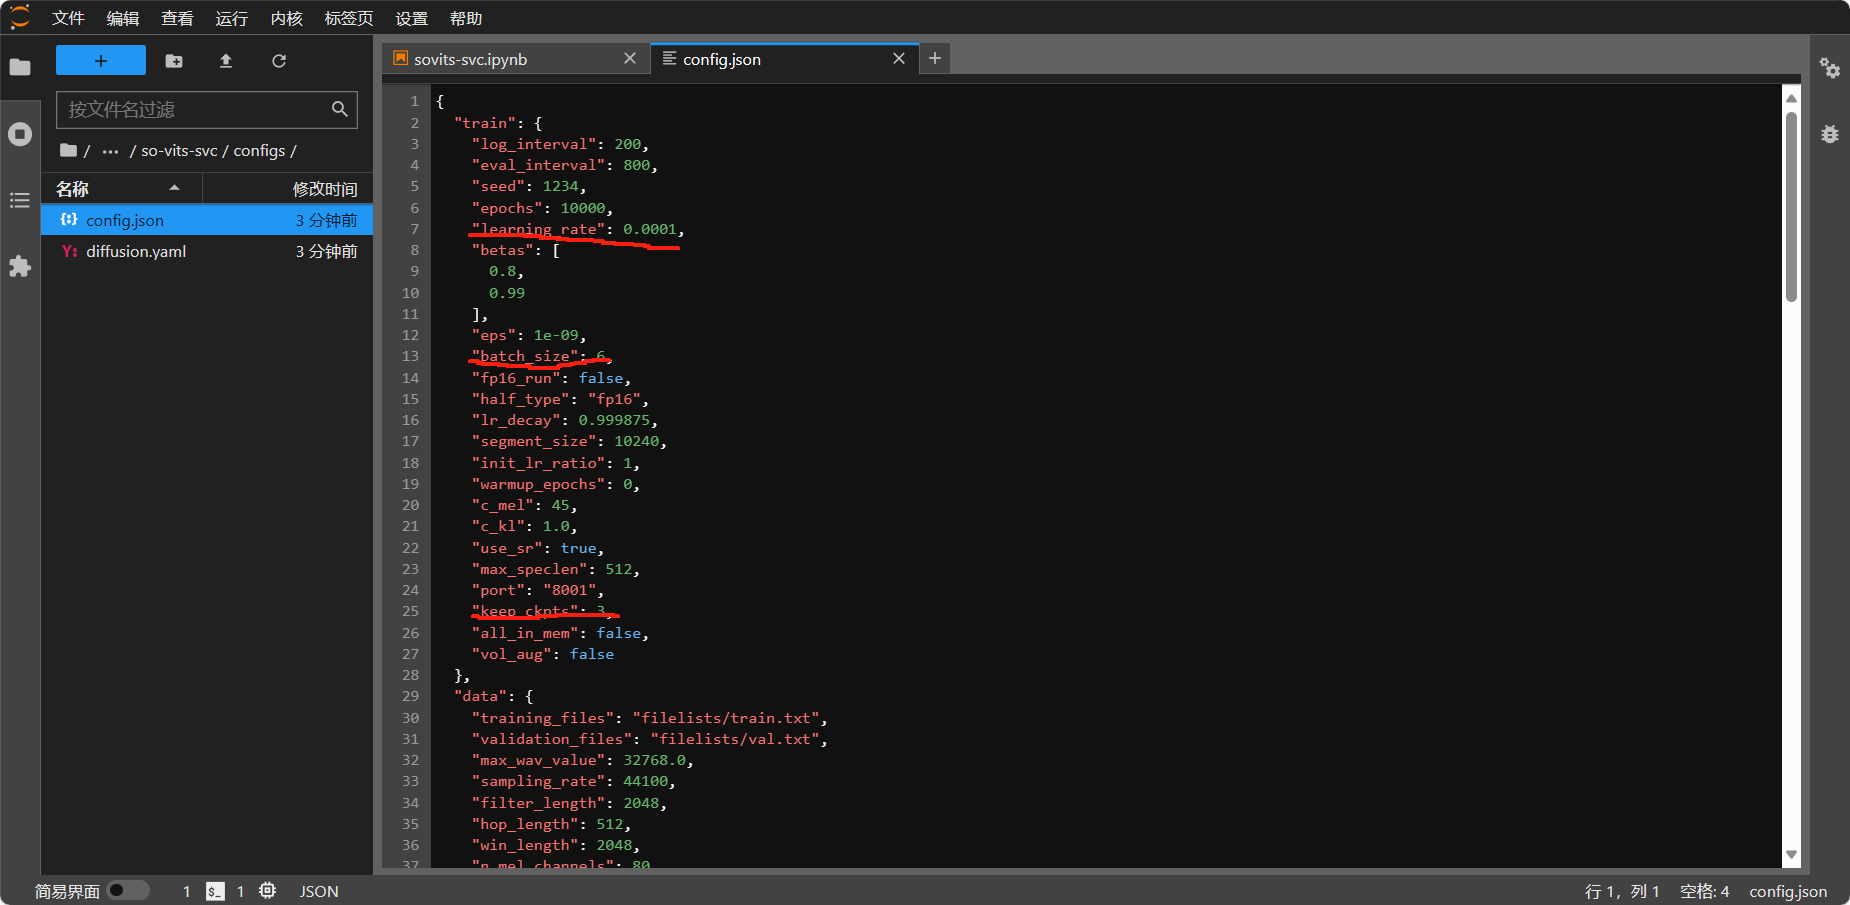
较为重要的参数是$learning _ rate$,$batch _size$,$keep _ ckpts$。
前两个参数需要按照比例来修改,比如0.0001-6,0.0002-12,并非是越大越好,这里我就选择将其改为0.0002-12,$keep _ ckpts$
改为10。
接下来选择f0预测器。
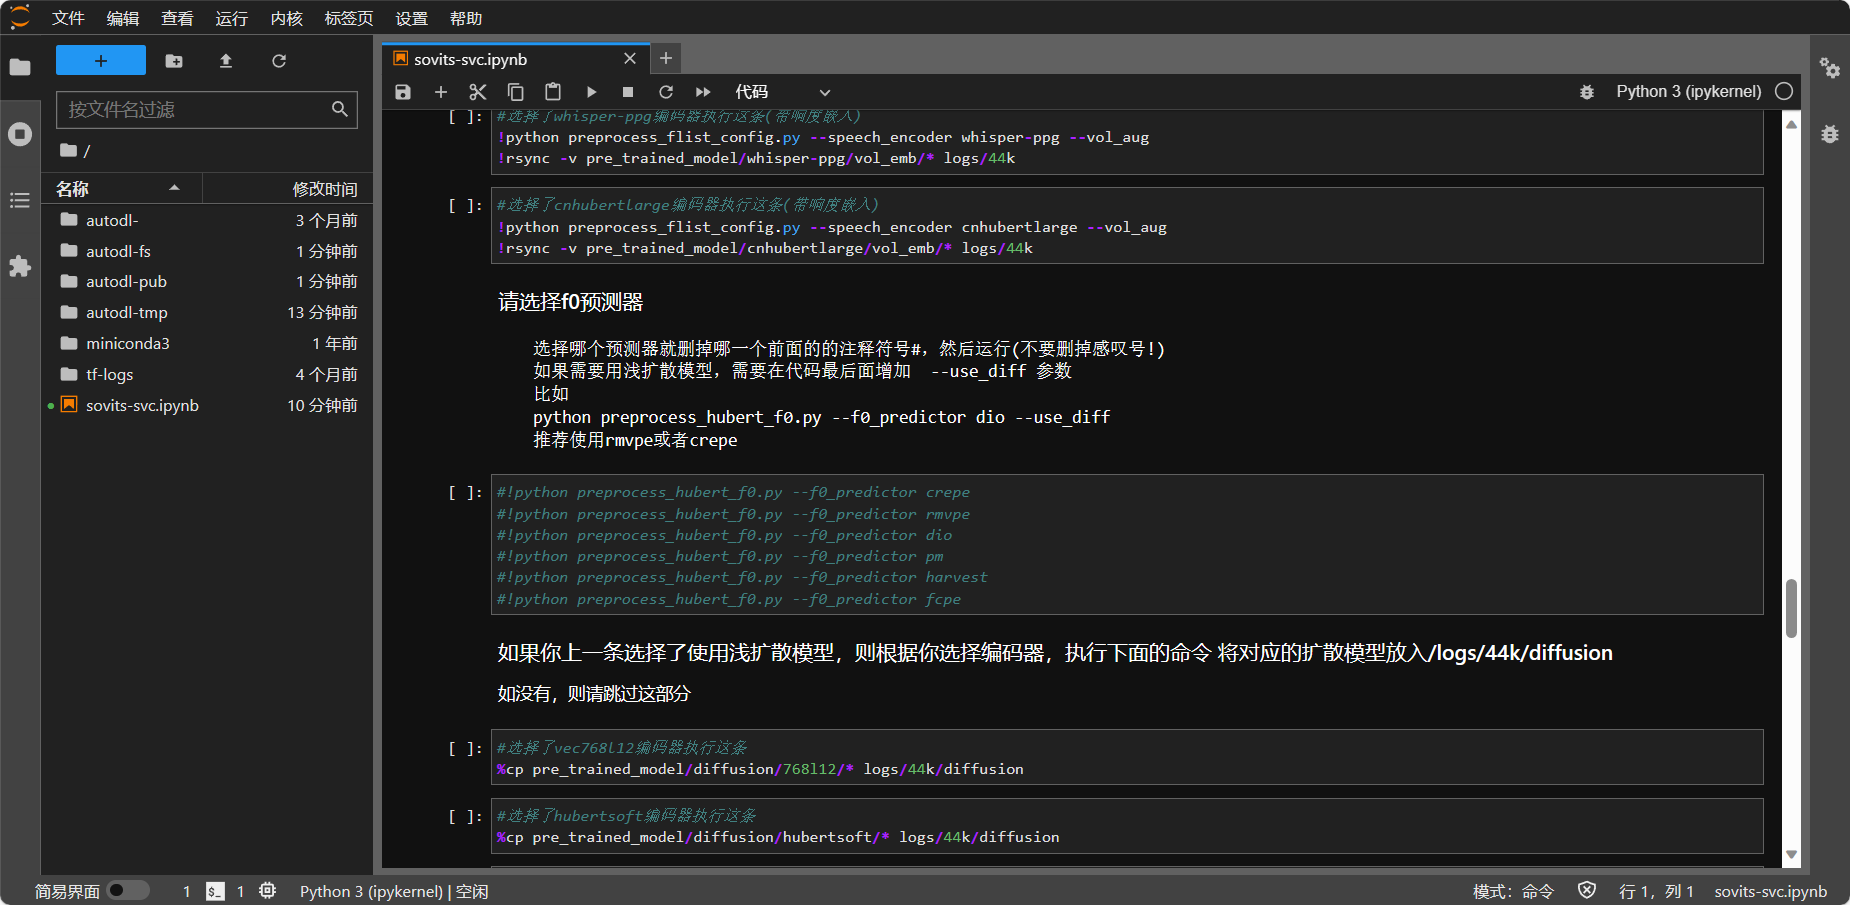
这里选择第二个,将代码前面注释的$#$号去掉,并在后面加上$—use _ diff$来进行浅扩散模型的训练。
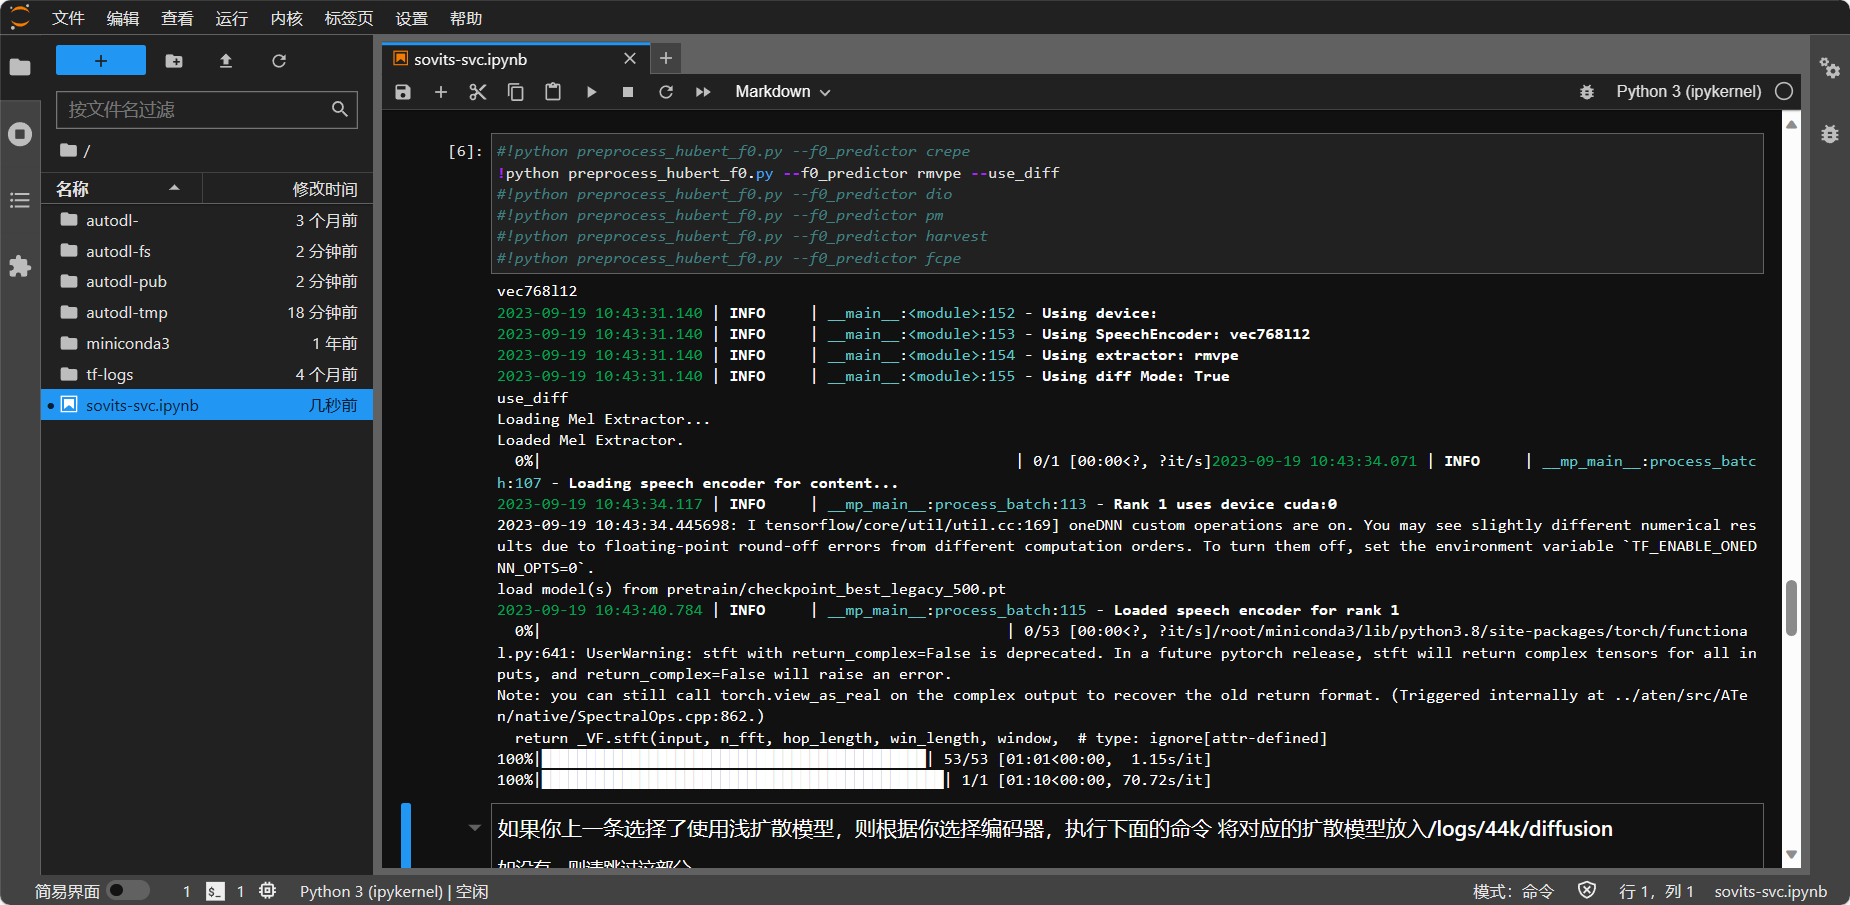
继续训练浅扩散模型,选择第一个。
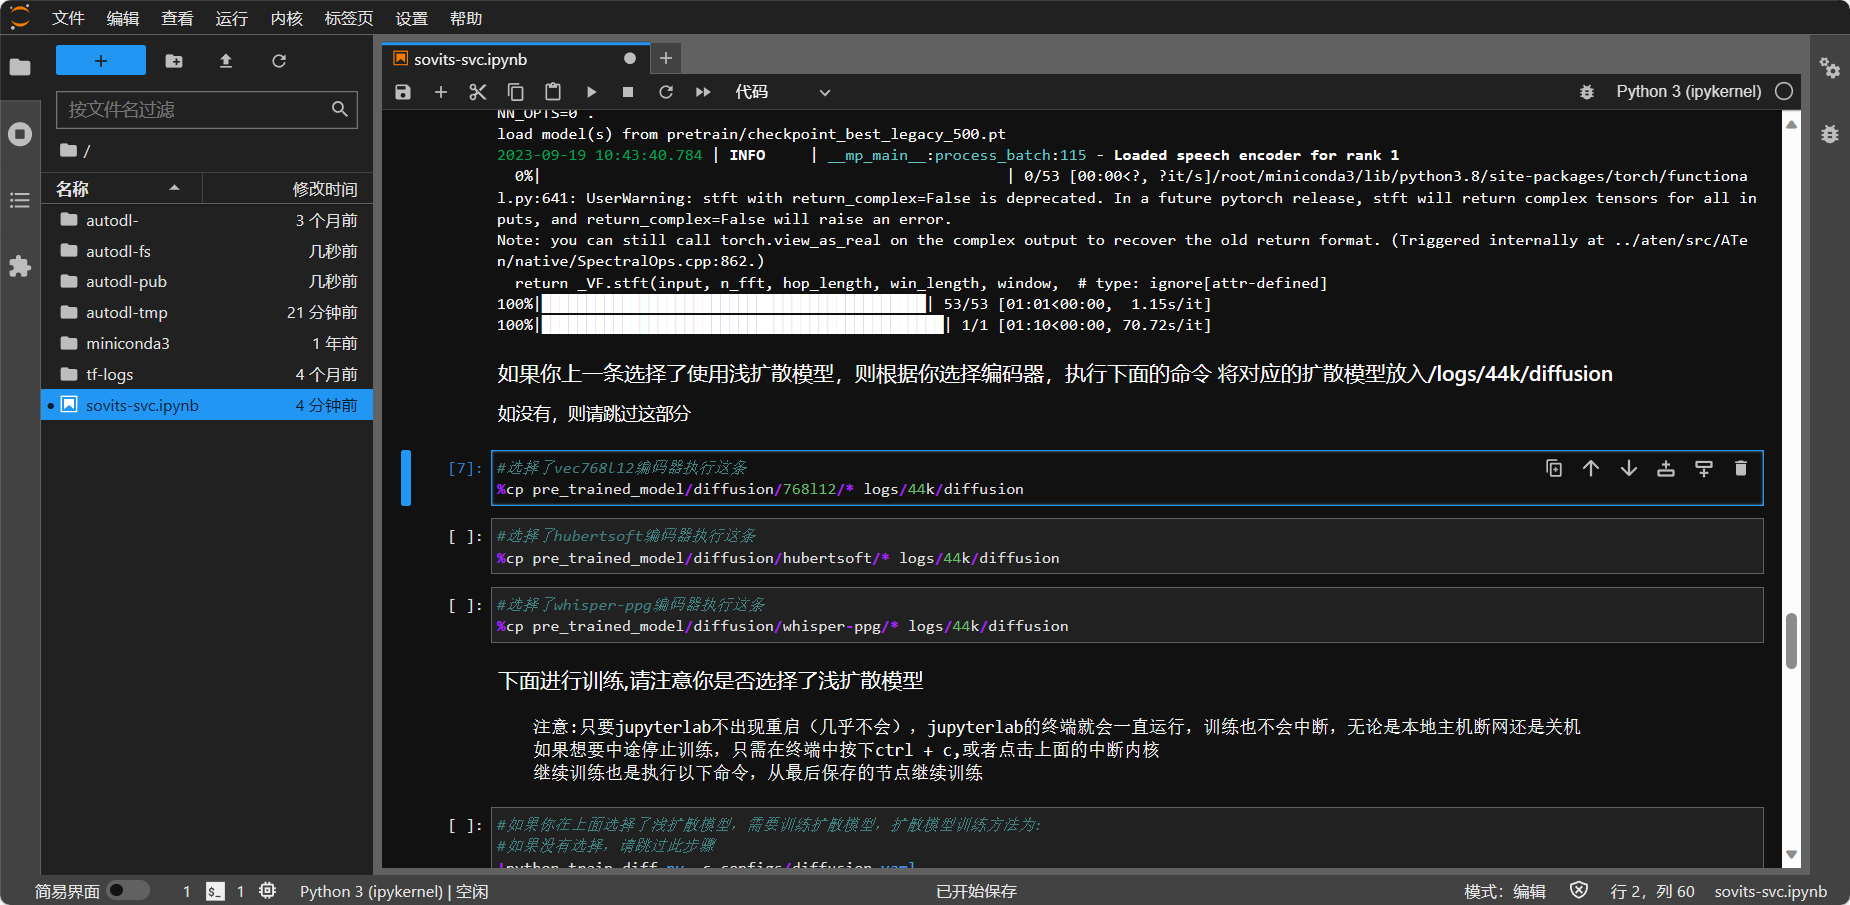
接下来就是开始训练了
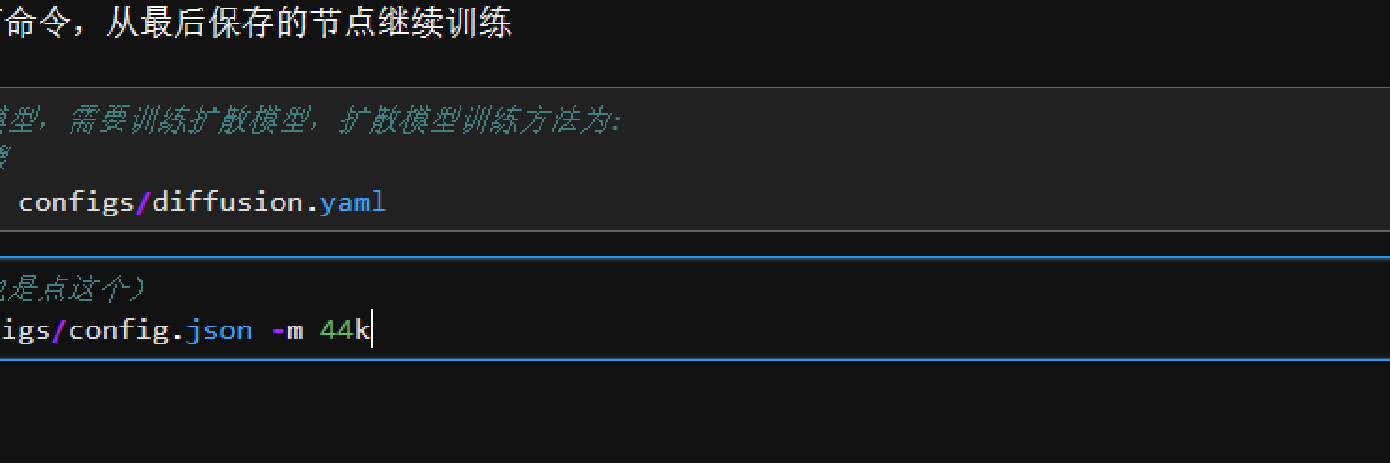
选择第二个,进行主模型训练。
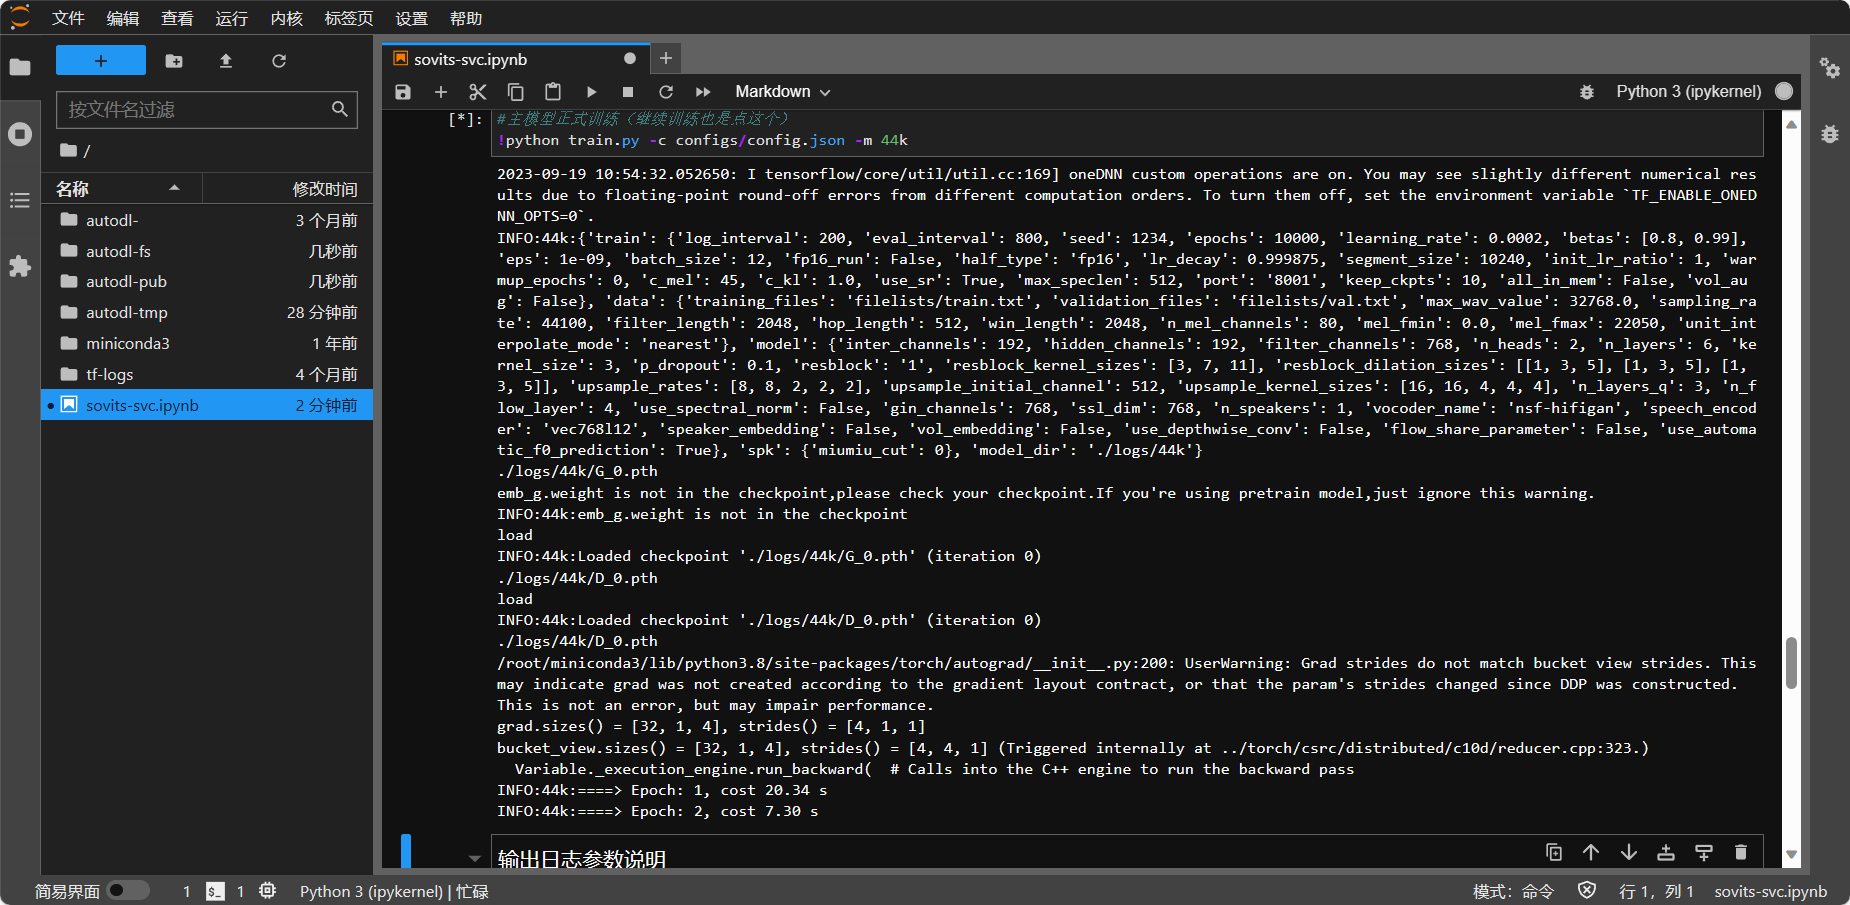
接下来静静等待他训练完就行了,这个时候只要不将云端关机,即使关闭了页面或关闭了自己的电脑,云端依然会继续训练。
一般模型训练到20000次以上就能打到很好的效果了